
KV Cache 与分页管理设计
为什么只缓存 K/V,如何用页池、页表与清晰的模块边界管理缓存。
核心设计:KV Management和前缀缓存
v0 解决如何把Qwen3跑通。 v1 解决主要减少计算量,把重复计算的Key和Value节省下来,并且把缓存模块接到现在的Engine和Model上。
v0的核心性能瓶颈是什么?#
在大模型中,生成的过程主要分为Prefill和Decode两个阶段。整个生成过程本质是前向重复执行。
假设prompt有10个token,整个计算流程大致如下:
[p0 p1 ... p9][p0 p1 ... p9 g1][p0 p1 ... p9 g1 g2]...[p0 p1 ... p9 g1 g2 g3 g4]可以发现v0的核心缺点是每一轮计算都会从第一个prompt的token开始,把整个序列都重新送入到模型。尤其是Attention中的QKV都是当场重新计算的。
那这样做会存在什么问题呢?
1.1. 计算量暴增#
自回归里,第t步要预测下一个token,Attention必须看见位置 的k/v。于是需要重新生成前边t-1个KV值。 而decode的Attention工作量是近似按照 增长的,因此面对长上下文时,吞吐和延迟会暴涨。
1.2. 显存碎片化#
换个思路,我们按照最大输出长度给每条请求预留个显存内存,这样做确实可以消除重复计算,但是在面对输入长度不可知时会大量预留,产生碎片。KV缓存不能只做一个大 tensor 粘在模型上,而应该设计一个类似内存池的东西,对整个池子进行高效管理。
因此,v1模块的核心设计原则是:存储KV,管理KV。
为什么只有 KV 可以被缓存?#
想要减少重复计算,自然会想到把某些算过一次的结果存下来。 但模型里有那么多中间量,为什么偏偏是 K/V?
在一次模型前向传播中,按照性质可以分为以下三类:
| 类别 | 包含哪些 | 基本特征 |
|---|---|---|
| 模型参数 | 各层 Linear 权重、RMSNorm weight、embedding表 | 推理中保持不变,常驻显存 |
| 逐 token 中间量 | hidden state、norm 输出、Q/K/V、MLP 中间激活、logits | 根据Token产生的中间量 |
可以发现需要缓存的就是逐token的中间量。 一个中间量能够缓存,需要满足两个条件:
- 内容有效。在后续的token计算出来中,并不会发生改变。
- 被重复使用。后续的计算要不断引用该参数。
Key和value恰好满足这两个条件。
首先,位置i的K只依赖自己的hidden state(经过逐token的norm、RoPE和投影),而位置i的hidden state在生成第i个token时候已经确定下来,后续无论来多少新的token,都不会再改变。因此第i个token的KV是永远有效的。
其次,生成新的token时,Q需要和历史KV做点积,所以历史的KV会被反复查询,即每来一个新的token,都需要用一遍历史KV。
而其他模块则都是和token相关的,每次生成新的token,都需要实时计算,因此没有缓存的基础。
KV Cache的管理#
为了解决重复计算的问题,KV-Cache应运而生。它的思想非常简单: KV Cache可以让模型在输出过程中,每个 token 的 K/V 只算一次;之后每一步生成只负责算新 token 的 K/V 并追加,计算Attention的时候 再把缓存里的历史 + 当前生成的新token拼起来做注意力。
既然KV Cache这么好用,那为什么还有有vLLM的PagedAttention呢? 这是因为最初的KV Cache特性(连续的物理内存)会带来严重的显存管理问题。
- 内部碎片。为了保证有足够的空间,每一个模型通常都会申请开一块非常大的连续内存,例如一次性可以容纳2048个词的Cache。如果一个用户的请求很短,例如只发了一个:你好。那么剩下的大部分空间就被彻底浪费掉了。
- 外部碎片。上述问题还只是针对单个用户和单个模型。而当我们扩展到多个用户并发处理请求时,情况就又发生了更严重的变化,显存会被切割成为许多不连续的小块。当一个长请求到来时,即使剩下的显存还是很多,但是系统却没办法找到一块足够大的连续空间来满足它。
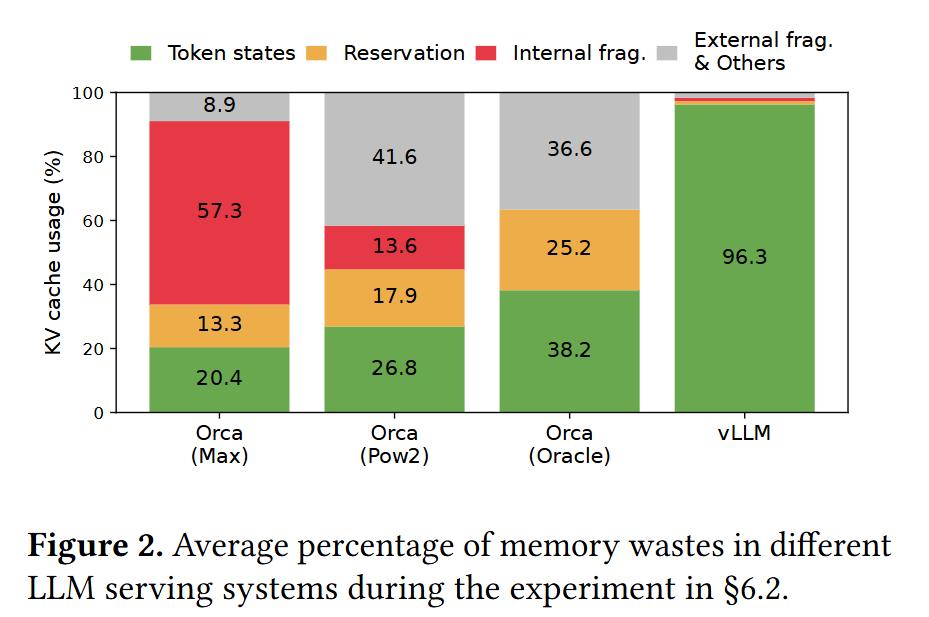
显存闲置情况
实际上,vllm之前的方法都很难完全利用到整个显存,但是vllm却几乎能够把显存完全占满,那这是怎么做到的呢?
vllm通过一种名为PagedAttention的技术,动态地在内存池中为KV Cache分配显存,以提高显存的利用率。
简单来说,这就是GPU版本的虚拟内存分页管理技术。
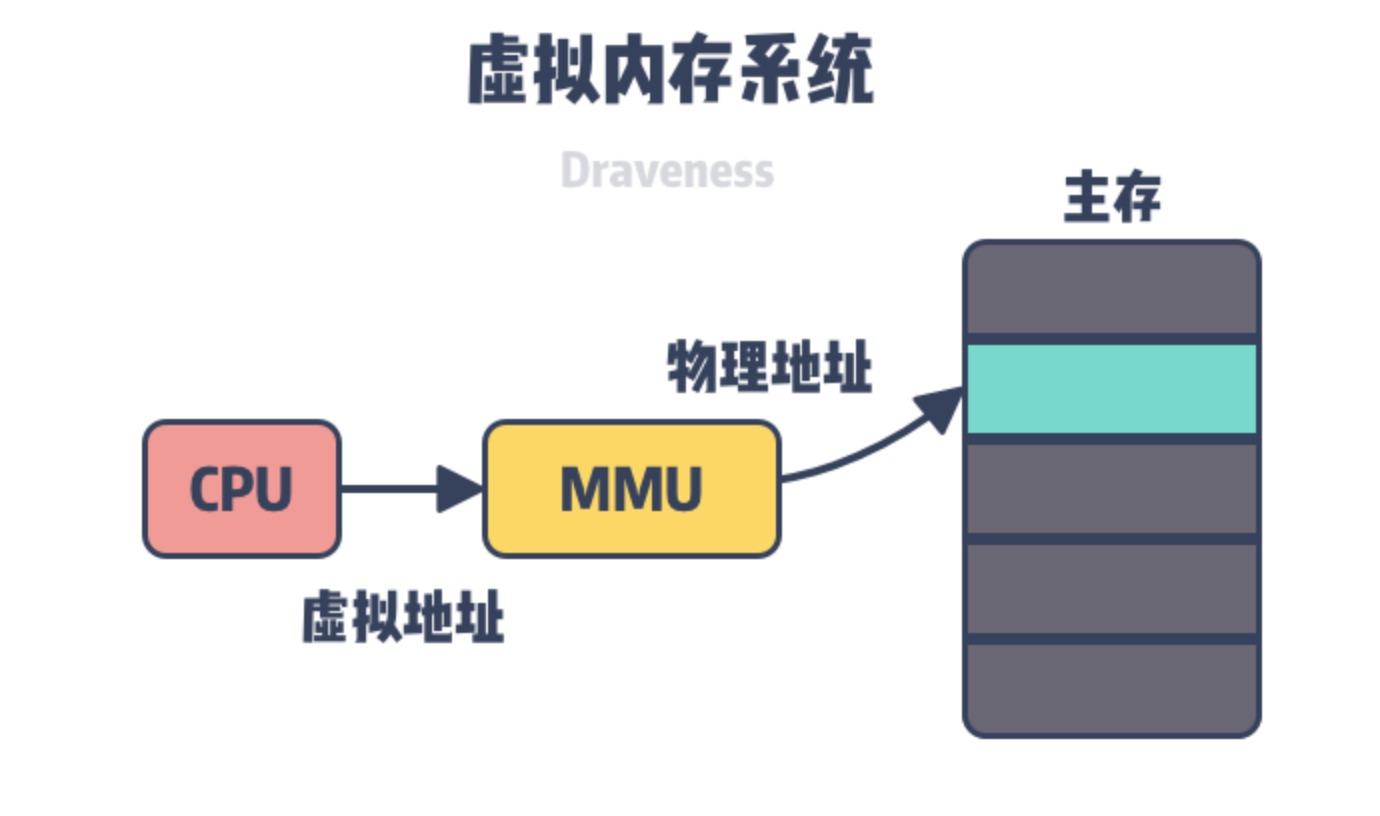
这一项技术首先被UC Berkley的研究者提出来,它对KV Cache的管理机制进行了彻底的重构:
- 分块。将KV Cache不再视为一个整体,而是在逻辑上切分成许多固定大小的Block,每个Bock可以存储固定数量Token的Key和Value。
- 页表。系统为每一个请求(Sequence)都维护一个独立的页表。它的核心作用是记录该请求的每一个逻辑Block分别存储在物理的哪一个Block上,也就是地址映射。
- 内存管理器。有了页表,有了逻辑,还需要对GPU的实际显存进行管理,什么时候进行分配,什么时候进行回收,都需要一个Manager进行操作。
KV-Cache是典型的空间换取时间:
- Prefill:把 prompt尚未在缓存里的那一段过一遍模型,把得到的 K/V 写入缓存。这一步仍可能处理较长序列,但是一次性计算。
- Decode:每一轮模型输入长度变为 1。新算出的 K/V 添加进缓存;做 Attention 时 读出长度为当前总序列的 K/V,再和长度为 1 的 Q 做 SDPA。
因此 Cache 的主要收益是 算力。decode 从每步重算整段,变成每步只算增量。
第二性收益是 显存形态与 跨请求复用。页式存放可以减少预留浪费;前缀索引让相同 prompt 前缀不必再 prefill 一遍。
KV 管理的设计理念#
这个时候我们要阅读vllm源码了吗? 不!我们需要自己手写,把上述说到的所有模块都自己实现。当然,这个地方存在很多涉及到性能、百花齐放的架构适配,这些我们先暂时忽略,只保留核心主干。
明确了要缓存 K/V,还要管得住显存,真正难的其实不是阅读vllm,而是我们怎么把这一套设计划分好任务边界。如果把所有事塞进一个超级 Manager,后面任何改动都会牵一发而动全身。
我用一个例子来带大家体会一下KV Management的逻辑设计:
北邮旁边有一个金谷园饺子店,有很多桌位,人们会来这里吃饺子。
理念一:逻辑与物理分开 从顾客的角度来说,每一个人拿到的都是一个连续的号码,例如A01、A02等号码,但是实际上坐到的地方可能是33号、68号桌子等等,物理位置和逻辑位置是分离的。 顾客只需要知道自己是逻辑第几位就可以了,并不关心桌子在哪,对照着表来映射即可。
同理,操作系统管理内存的关键,并不是把一块巨大的 RAM 直接裸给进程,而是让进程看见连续的虚拟地址,每一个进程都有完整的地址映射空间,但是硬件上是一页一页不连续的物理页,中间靠页表翻译。
KV 也一样。一条请求在逻辑上拥有从第 0 个 token 往后连续增长的地址空间;GPU 上则是预先划好的固定大小页池,请求变长就多拿几页,用完再还。请求不需要知道某页落在显存的哪一片连续区间。
理念二:管资源与做存储分开。
在金谷园有一个非常特殊的岗位,门口查看监控的阿姨。她实际上是在管理资源,谁来了坐哪张桌子?是坐小桌子还是大桌子?前边一桌的人是不是已经吃完空出来了等等?这个其实是资源管理。
而还有保洁员,需要对上一桌子的残羹剩饭进行清理,以及摆放新的餐具,并且通知给前台阿姨。这个阿姨是实际上在管理各个桌子的”读写”。
那么从KV的角度来说,一旦有了页,就会分成两类问题。第一类偏资源与生命周期:这页现在归谁,前缀能不能复用,请求结束是留下还是回收?第二类偏存储怎么访问:已经知道页号之后,怎样把算出来的 K/V 写进张量,怎样按逻辑顺序读回来给 Attention?对应到代码,KVManager就是前台,PagedStore就是保洁员。
理念三:编排与计算分开。 保洁不需要知道来了多少人,前台也并不关心保洁的工作,顾客更是不担心桌子是否收拾好,因此它们都是有权责边界的。
并且它们之间是有状态切换和先后顺序调度的,因此Engine就需要管理,什么时候告诉保洁、什么时候告诉顾客,什么时候更新前台信息等等。
编排层告诉计算层这一步的规则,计算层按规则读写 Cache。
KV management的效果#
- Decode 吞吐提升。历史 K/V 直接读 Cache,每步只算当前 token;Attention 输入长度从整段 降到 。这是 tok/s 提升的主因。
- 显存利用率提高。K/V 按页按需占用:短请求少占页,结束后页回池,同一块物理显存可被多轮请求轮转使用,减少显存浪费。
- 多请求可共池调度。页池在请求间共享,变长序列不必各占一块连续大缓冲,为后续 Continuous Batching 提供显存侧基础。
- 相同前缀的 Prefill 可被跳过。满块 K/V 可经 hash/radix 索引跨请求复用;命中时直接接在已有 Cache 上继续算,省掉重复 Prefill 的算力与时间。