
ZOS 异步调度的实现与效果
我们把下一轮的输入准备与 GPU 计算重叠起来,并用两个模型的实测观察收益。
GPU 已经算完了,下一个 token 为什么还没有开始计算?
我们在前面优化了 Attention、算子融合和 CUDA Graph。把一次 decode 放回完整的执行过程,GPU 计算之外还有组批、结果回读和请求状态更新。单个算子变快以后,这些工作在每步耗时中的占比也会逐渐显现。
ZOS(Zero-Overhead Scheduling)会提前准备并提交下一轮计算,让 CPU 的部分工作与 GPU 计算重叠。GPU 按 token 依赖继续计算,CPU 在下一轮提交后确认上一轮结果。
同步 decode 中的等待#
我们先看普通的同步流程。GPU 完成第 N 轮前向与采样,CPU 读回 token,检查请求是否结束,更新序列和 KV 状态,然后准备第 N+1 轮。
GPU 计算 N → CPU 处理结果并准备下一轮 → GPU 计算 N+1假设 GPU 计算需要 ,两轮之间的 CPU 工作需要 ,同步流程的步时就接近 。我们把 CPU 工作安排到 GPU 计算期间,两边就有机会同时推进,理想步时也会向 靠近。
下一轮的位置、所需 KV 页数和请求行序,通常可以提前确定。输入 token 的数值则来自上一轮采样。我们可以把准备这些元数据的工作交给 CPU,让 GPU 继续传递真实 token。
NanoFlow 中的异步组批#
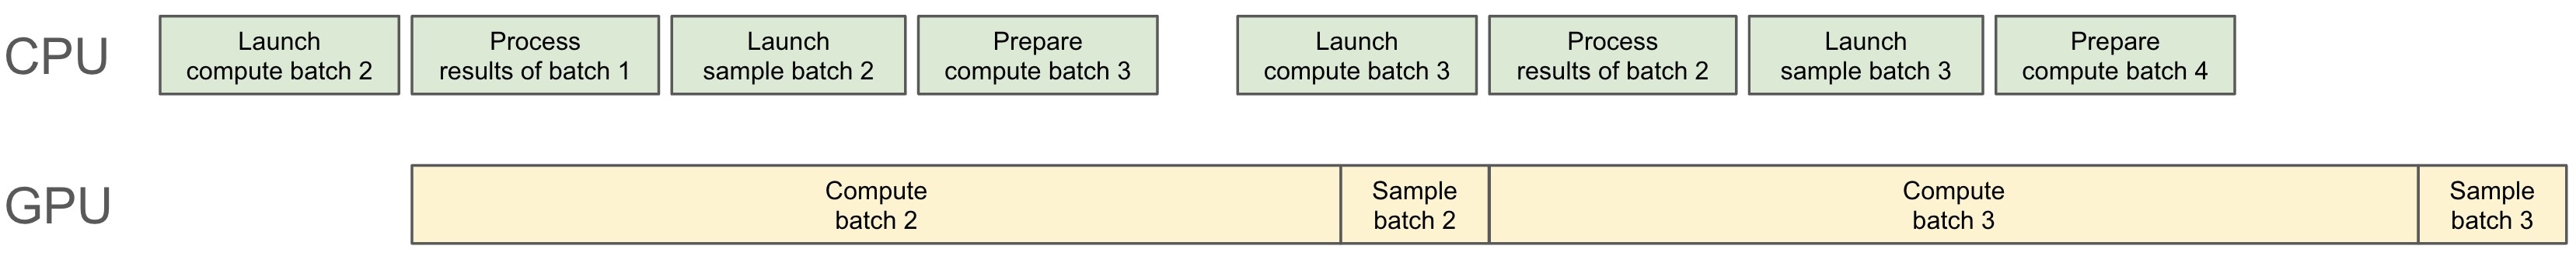
NanoFlow 在 2024 年初稿第 5.3 节介绍了异步顶层调度。GPU 执行当前轮次时,CPU 就开始决定下一轮的 batch,并分配 KV 页面。下一轮提交以后,CPU 再检查上一轮的结束状态。NanoFlow 论文第 5.3 节
这时,CPU 确认结果会落后 GPU 一轮。假设第 N 轮生成了 EOS,第 N+1 轮可能已经提交。CPU 确认请求结束后,会在第 N+2 轮组批时移除它,因此可能多算一个 token。论文 Figure 9
我们用这一步额外计算,换取组批和 KV 管理与 GPU 计算重叠的空间。请求结束后的输出截断和页面回收,也随之成为异步调度的一部分。
SGLang 如何准备下一轮输入#
SGLang 在 2024 年 12 月发布 v0.4,沿用了 NanoFlow 提前一轮组批的思路,并实现了 Zero-Overhead Batch Scheduler。SGLang 发布文章
我们可以用两条请求理解输入的传递。CPU 已经记录了 A 的 8 个 token 和 B 的 12 个 token。假设上一轮 GPU 输出分别为 41、57,CPU 还没有读回这两个数值。
| 请求 | CPU 已记录的长度 | 下一轮输入位置 | GPU 上的输入 token |
|---|---|---|---|
| A | 8 | 8 | 41 |
| B | 12 | 12 | 57 |
我们已经知道下一轮的位置和 KV 地址,可以先准备 batch。GPU 执行到下一轮时,直接使用上一轮采样得到的 41、57。CPU 随后把这两个 token 写入自己的序列记录,并检查请求是否结束。
SGLang 用 future ID 标记尚未读回的输出。CPU 使用这个标识继续组批,GPU 再通过设备端映射找到真实 token。早期实现通过调度循环、worker 线程、队列和 CUDA event 配合,让本轮提交先于上一轮结果处理。早期 worker、对应的调度器
图中下半部分,CPU 先准备并提交 N+1,再处理 N 的结果,GPU 按 token 依赖依次执行。我们也可以对照官方时序图观察线程之间的安排。
DeepInfer 进一步处理了动态 batch 和 MTP。一轮可能接受多个 token,前后两轮的请求行序也可能变化,因此它会记录行映射和实际接受长度。我们在 V3 中保留了稳定行序、逐 token greedy decode 的执行路径。DeepInfer worker、ZOS 元数据
我们在 V3 中的执行过程#
我们让下一轮的位置和有效长度领先 CPU 的确认状态一步。上面的请求 A,CPU 长度仍为 8,GPU 使用位置 8、有效长度 9 和采样得到的 token 41。下一轮提交后,CPU 再处理上一轮结果,更新自己的序列。
在这个基础上,我们把稳定 decode 中的位置递增、长度递增和输入 token 更新合并到一个小 kernel。GPU 可以沿用常驻元数据,CPU 在新增 KV 页或页号变化时刷新设备页表,逐轮复制完整 token 历史的工作也随之省去。
普通 decode 的元数据则打包到一块连续缓冲区。greedy 采样直接取最大 logits,温度、top-p 等参数无需逐轮上传,这条路径的元数据 H2D 从每步 9 次合并为 1 次。同步路径也使用这套输入准备方式。
我们还复用了输入暂存区、结果回读缓冲和完成事件。CPU 再次写入某组暂存区以前,会先确认上一笔 H2D 已经读取完成。greedy 采样返回独立张量,我们让待确认结果持有它,省去每轮额外的样本克隆。
代码中的对应关系
- 我们用
DecodeTicket保存待确认的 GPU 样本、CPU 回读区和完成事件,pending指向当前待确认结果。 src/control/async_decode.py检查请求行序、长度上限和可用页面,安排提前提交与结果确认,并分别记录流水暂停的原因。src/data/batch.py中的DecodeInputs负责打包输入和复用暂存区,src/compute/decode_inputs.py推进设备端元数据。src/compute/model_runner.py执行模型与采样,CUDA Graph 绑定固定的输入地址。
我们使用 enable_zos=True、enforce_eager=False 和 greedy 采样运行下面的测试。其他采样方式沿用同步路径。
请求结束与 KV 页面回收#
提前提交以后,一个请求可能已经在第 N 轮生成 EOS,第 N+1 轮却仍在访问它的 KV 页面。我们会保留 EOS 处的输出,丢弃额外一步的结果,等在途访问完成后再回收页面,让后续请求安全复用。
radix 前缀缓存发布完整前缀时,可能把页号替换为已有的相同前缀页。我们会在这个边界等待已提交的计算完成,再允许替换,并在后续计算前刷新 GPU 页表。
新请求加入、批次或行序变化、长度达到上限、KV 页面不足时,我们会先确认在途结果,再交回普通调度。批次缩小后,CUDA Graph 补齐行的写入位置会设为 -1,有效长度清零。下一轮重新使用有效请求的输入和地址。
KV 管理器的回调使用弱引用,重建缓存后,旧实例可以随所属对象一起释放。这样,我们把请求结束、页面复用和缓存实例释放放在各自明确的生命周期中处理。
两个模型的实测效果#
我们在同一张 RTX 5090 D v2 上测试 Qwen3-0.6B 和 Qwen3-1.7B,使用 FP16、greedy 和 CUDA Graph,关闭 prefix cache 与 prefill compile。
这次分别延长了生成时长、增加输入长度和扩大 batch。每组预热后交替测量同步与 ZOS,各计时五次。下表的加速比为同步耗时中位数除以 ZOS 耗时中位数。
| 初始输入 token | 输出 token | Batch | 0.6B 加速比 | 1.7B 加速比 |
|---|---|---|---|---|
| 128 | 1024 | 8 | 1.056× | 1.032× |
| 4096 | 512 | 16 | 1.024× | 1.020× |
| 1024 | 512 | 48 | 1.029× | 1.019× |
持续生成 1024 个 token 时,0.6B 的吞吐提升约为 5.6%,1.7B 约为 3.2%。输入增加到 4096 token 后,提升分别约为 2.4% 和 2.0%。更长的输入增加了 GPU 计算,CPU 准备工作在总步时中的占比随之变化。
以 1.7B 为例,长输入场景的单步耗时从 12.044 ms 降到 11.808 ms,节省约 0.236 ms。短输入持续解码时,从 4.976 ms 降到 4.821 ms,节省约 0.155 ms。前者节省的绝对时间更多,提升比例仍然较小。
这些计时区间约为 2.6~6.2 秒,覆盖的 30 对完整输出逐 token 一致。我们同时保留了每次耗时和输出摘要,便于继续对照不同负载。
测试条件与复现
表中的输入指初始 prompt 长度,生成期间上下文会持续增长。prefill 和预热位于计时之外,每条请求生成 个 token,计时覆盖第一个输出之后的 个 token,吞吐为 。循环内部保留异步关系,只在完整计时区间两端同步。
软件环境为 PyTorch 2.13.0+cu130、FlashAttention 2.8.3、FlashInfer 0.7.2.post1,CPU 张量计算线程数为 1。原始记录位于 bench/records/zos-expanded-0.6b-2026-10-30.txt 和 zos-expanded-1.7b-2026-10-30.txt,图表直接读取这两份记录生成。
我们可以用下面的参数复现长输入场景。
python vllm-v3/bench/bench_zos.py \ --model /path/to/Qwen3-1.7B --modes cg \ --batches 16 --prompt-lengths 4096 --output-tokens 512 \ --repeats 5 --warmup 2 --out vllm-v3/bench/out/zos-long-promptSGLang v0.4 发布时报告约 1.1× 的调度收益,复现示例使用 Llama-3.2-3B、500 个请求和更长的输出。我们这里测量单卡固定 batch 的纯 decode,CPU 与 GPU 的耗时比例也随工作负载变化。官方结果
动态组批中的数值差异
我们把相同批次下的逐 token 核对与动态组批数值审计分别记录。在一个 9 请求的合成例子中,同步路径的两个最高 logits 都是 17.203125,异步路径其中一个为 17.1875,相差一个 FP16 刻度,最后一个 token 的选择随之改变。旧版也复现了同一分歧。
动态组批会改变浮点计算的组织方式,近似平票时,细小差别可能影响 greedy 选择。我们保留分歧位置、候选分数和对应输入,继续按原有标准记录输出一致性。PyTorch 数值精度说明