
数据并行的前世今生
复制模型能提高吞吐,为什么加卡仍会 OOM?从 DDP 的显存冗余到 ZeRO、FSDP 的通信代价,讲清数据并行的优势与瓶颈。
兄弟们,我现在有 100 张 H100,跑个 DeepSeek 应该随随便便吧?哎,怎么还是 OOM 了?我这机器这么多,怎么连模型都加载不进去?
如果直接用普通 DDP 训练 DeepSeek-V3,确实会卡在加载模型这一步。按它的 671B 参数估算,BF16 权重就要占大约 1.34 TB,而 DDP 要求每张卡各放一份完整模型。100 张卡的显存加起来再大,也解决不了单卡放不下的问题。DeepSeek-V3 技术报告
多卡训练的并行方式主要分为数据并行和模型并行。数据并行让不同设备处理不同的训练样本,模型并行则把模型的计算分配到不同设备上,常见的有张量并行和流水线并行。
后来的 ZeRO、FSDP 在数据并行的基础上引入了训练状态分片,逐步缓解单卡显存限制。
数据并行的基本流程#
我们可以通过一个小模型来分析数据并行的执行过程。假设一个 batch 有 32 条样本,交给 4 张 GPU,每张卡处理 8 条。各卡保存相同的完整模型,分别对自己的数据进行前向和反向计算。
由于各卡独立执行相同的模型,原有计算代码基本可以保留,并行训练主要增加了数据分配和梯度同步。PyTorch 中对应的常用实现叫作 DistributedDataParallel,简称 DDP。
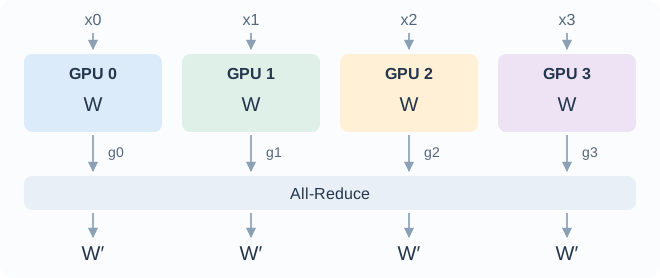
图中的 到 表示各卡的输入, 表示相同的模型参数。由于输入不同,各卡计算出的梯度 到 通常也不同。如果直接用本地梯度更新,各卡的模型参数就会产生差异。
因此,图中在梯度计算之后安排了 All-Reduce,让各卡获得相同的平均梯度,再分别执行参数更新。相同的初始状态、梯度和更新规则会得到相同的结果,也就是图中各卡相同的 。DDP API 文档
设第 张卡的局部平均损失为 ,数据并行规模为 ,各卡有效样本数相同时,这个平均梯度可以写成
DistBelief(2012,Google)#
2012 年,Google 在 Large Scale Distributed Deep Networks 中介绍了 DistBelief。它是一套分布式训练系统,可以利用成千上万颗 CPU 核心训练神经网络。其中的 Downpour SGD 让多个模型副本处理不同数据,共同训练同一个模型。
我们可以通过下图理解它的做法。下方每个 worker 都运行一个模型副本,处理各自的数据;上方的参数服务器负责保存和更新模型参数。worker 计算出梯度后发给参数服务器,再从服务器获取更新后的参数,继续训练。
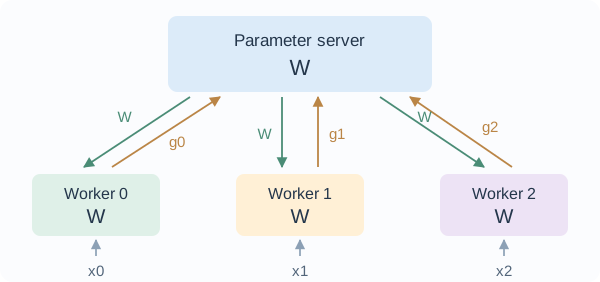
图中的 表示模型参数,、、 表示各 worker 算出的梯度。不同数据产生的梯度最终都用于更新服务器上的参数,所以这些副本是在合作训练一个模型。参数服务器是一个逻辑上的服务,可以由多台机器共同承担。
Downpour 还允许各 worker 独立提交梯度,哪个先算完就先参与更新,不必等其他副本。这样能减少等待,也可能收到基于旧参数计算的梯度。这就是它采用的异步训练方式。论文第 4.1 节
这套方案也把参数的收发集中到了参数服务器。随着 worker 增多,服务器需要处理的梯度和权重传输也会增加,通信逐渐成为影响扩展效率的重要因素。后面 Uber 使用分布式 TensorFlow 时,就遇到了这方面的麻烦。
Horovod(2017 / 2018,Uber)#
到了 2017 年,Uber 的一些模型已经要训练一周甚至更久,他们希望增加 GPU 来缩短训练时间。使用当时的 TensorFlow 1.x 多机训练时,用户需要分别启动负责计算的 worker 和更新参数的服务,再配置各进程的 IP、端口,以及计算使用的 GPU。单机训练之外,又多了一批需要配置和排查的代码。
参数服务器还要接收各 worker 的梯度,再向它们发送参数。如果 GPU 增加了,服务器和网络传输数据的速度没有跟上,worker 算完以后就得等待。于是,多买几张卡,并不一定能让训练按同样比例加速。
Uber 用 128 张 NVIDIA Pascal GPU 测试了 Inception V3 和 ResNet-101。对比的基准是理想线性扩展,也就是 GPU 数量翻倍,每秒处理的图片数量也翻倍。他们测到的吞吐明显低于这个理想值,并在原文中这样描述使用体验和扩展损失:
这里的资源损失,指实际吞吐相对理想扩展结果的不足,通信等待就是造成差距的原因之一。
Uber 随后把减少代码改动、提高通信效率作为 Horovod 的设计重点,在 2017 年发布项目,并于 2018 年发表论文。
在实现上,Uber 先参考百度的 TensorFlow Ring All-Reduce 代码,做成独立的 Python 包,后来又把底层通信替换成 NVIDIA NCCL。这些经过也记录在他们的发布文章中。
Horovod 的名字来自一种俄罗斯民间圆圈舞。按作者的解释,参与者牵手围成一圈,与 ring 通信的形式相似,因此采用了这个名字。Horovod 原文,第 4 节
Ring All-Reduce#
All-Reduce 的目标是把各卡张量归约,再让每张卡都拿到完整结果。以梯度求和为例,四张卡最后都应该得到 ,再按需要除以卡数。
Ring All-Reduce 把大张量切成若干块,让 GPU 沿环交换数据。它可以分成两个阶段:先用 Reduce-Scatter 让每张卡拿到一块已经归约好的结果,再用 All-Gather 把这些结果拼完整。
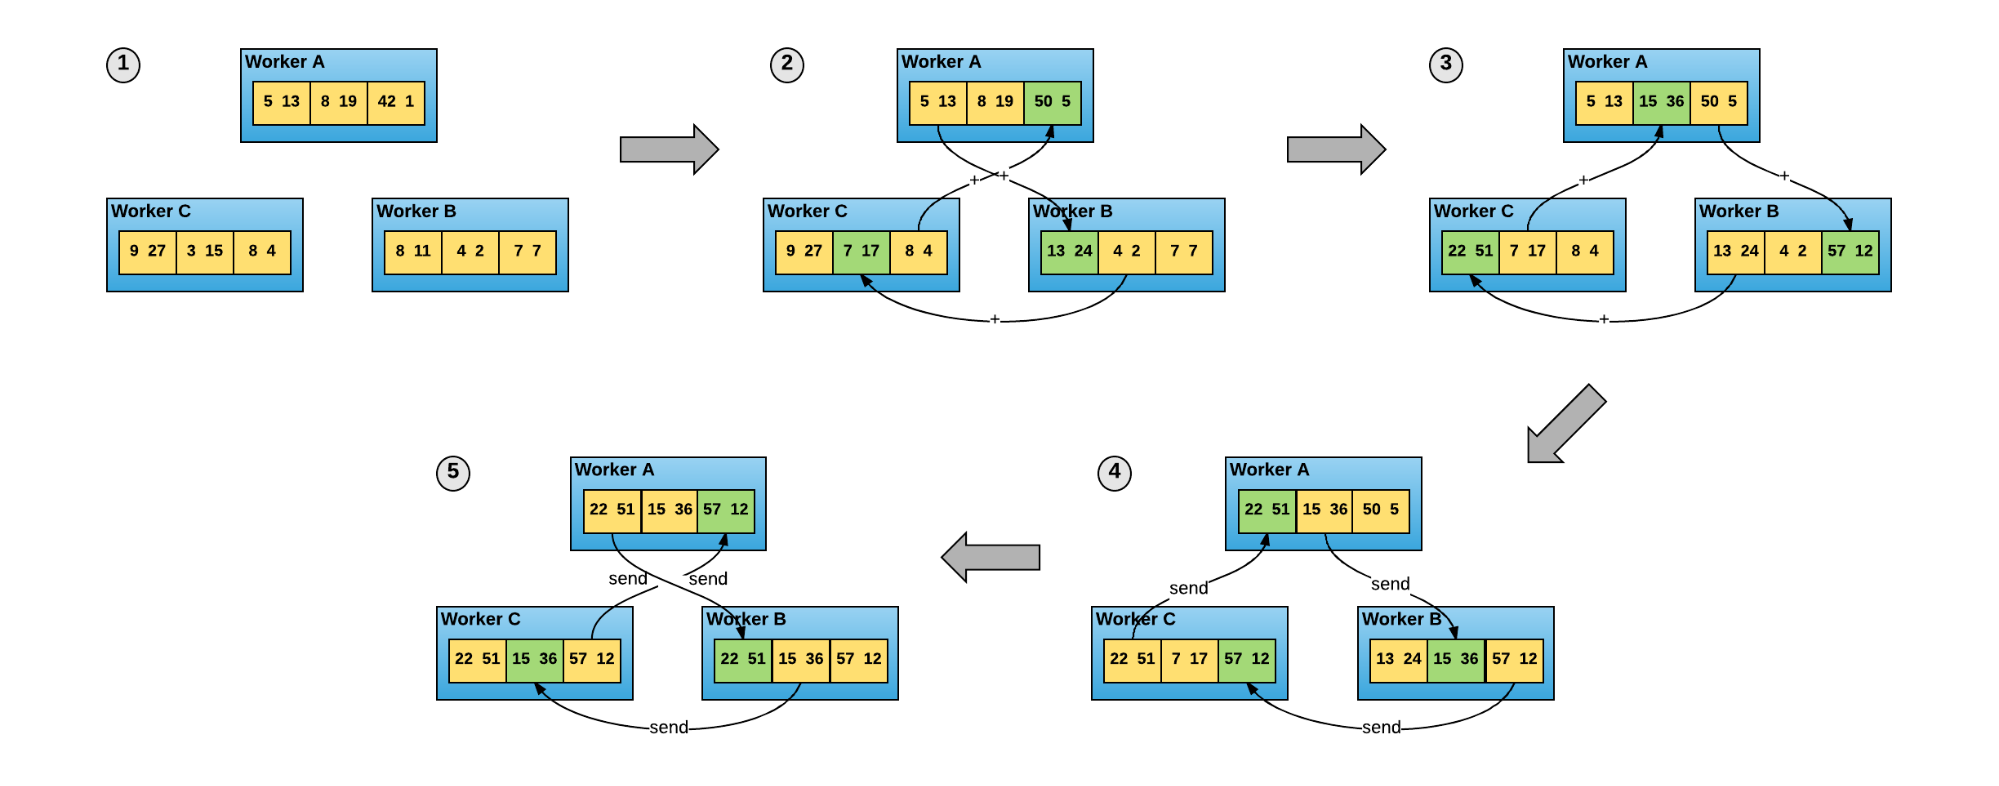
设梯度总大小为 字节,理想环算法中,每张卡在两个阶段合计发送约 字节,也会接收同样多的数据。卡数增加时,单卡传输字节数趋近 ,没有集中到某一台参数服务器上。
ring 的通信轮数会随卡数增长,小消息容易受启动延迟影响。实际使用时,NCCL 会根据消息大小和机器拓扑选择算法,因此 All-Reduce 并不一定都通过 ring 实现。
PyTorch DDP(2020)#
前面提到的是多机训练的配置,日常写模型时,TensorFlow 1.x 常见的静态图写法也有一些不便。我们在 Python 中写下张量运算,通常只是向计算图添加了操作,还要通过 Session 执行,才能得到结果。PyTorch 作者在 2019 年论文中,也将调试和灵活性列为静态图需要付出的代价。
PyTorch 采用直接执行张量运算的方式,模型代码更接近普通 Python 程序。我们可以在计算过程中打印中间结果、设置断点,顺着代码检查问题。对于经常修改模型、调试训练代码的同学来说,方便查看每一步的实际结果,就是一个很实用的改进。
从 DataParallel 到 DDP#
在 PyTorch 里,比较多卡方案时经常会看到 DP 和 DDP。这里的 DP 有两种用法:它可以泛指数据并行,也可以特指 nn.DataParallel。下面比较的是 nn.DataParallel 和 DistributedDataParallel,它们都属于数据并行的实现。
DataParallel 的用法比较方便,可以在原有模型外面加一层封装,使用单机上的多张 GPU。它在一个 Python 进程中,通过多个线程执行各卡的模型计算,每次前向还需要复制模型、分发输入,并将输出汇总到指定设备。
这些线程共享同一个 Python 解释器。在启用 GIL(全局解释器锁) 的 CPython 中,同一时刻只能有一个线程执行 Python 字节码,所以模型里的 Python 逻辑仍可能相互等待。GPU 算子本身可以并行执行,GIL 主要影响这里的 Python 执行和调度开销。Python 对 GIL 的说明
DDP 通常采用一张 GPU 对应一个独立进程的方式。各进程分别运行模型和训练循环,也有各自的 Python 解释器,避免多个模型线程竞争同一个 GIL。模型副本可以持续保留,各卡之间通过集合通信同步梯度,也能把训练扩展到多台机器上。PyTorch 的 DP / DDP 对比
所以,即使只有一台多卡机器,DDP 也有使用价值。它减少了线程竞争、每轮模型复制和输出集中汇总等开销。2020 年的 DDP 论文进一步介绍了框架怎样在尽量保留用户训练代码的同时,优化梯度同步。
补充一句,Python 3.14 已正式支持可选的无 GIL 版本,默认版本仍保留 GIL。它能让 DP 快多少,还得在兼容的 PyTorch 环境里测一测,感兴趣的同学可以继续试试。官方说明
梯度通信与反向计算重叠#
前面的示意图为了说明数据流,把反向传播和梯度同步分开画了出来。实际训练中,反向传播会逐层产生梯度。例如一个三层模型,第三层的梯度已经算完时,第二层和第一层还可能在计算。
这时,已经算出的梯度就有机会提前开始通信。DDP 会把多个参数的梯度组织成一组,称为 bucket(梯度桶)。一组梯度全部就绪后,就可以启动这一组的 All-Reduce,后续反向计算同时继续进行。DDP 的内部设计
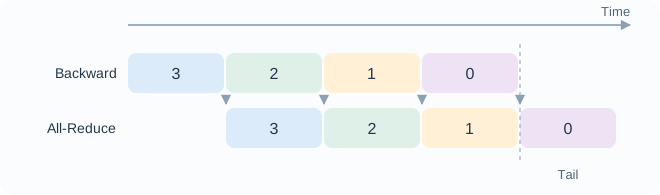
图中每种颜色对应一个 bucket。上面是反向计算,下面是梯度通信,两行重叠的部分表示它们可以同时进行。这样,通信占用的时间就不必全部额外加在反向计算之后。
Bucket 的大小#
实际上,bucket 的大小在 DDP 的设计中非常重要。如果桶分得比较小,里面的梯度更容易提前算齐,通信就可以更早开始。这样也会产生更多次通信,而每次通信的启动都需要时间,小消息太多以后,这部分开销就会增加。
如果桶分得比较大,通信次数会减少,一次也能发送更多数据。桶里包含的参数多了,就需要等更多梯度算完才能开始通信,原本可以和反向计算重叠的时间也可能缩短。因此,调整 bucket 大小时,需要结合模型的梯度产生顺序和实际通信速度来测量。
图中右下方还有一小段通信,发生在反向计算结束之后。此时本地梯度已经算完,优化器还要等各卡同步完成,才能使用平均梯度更新参数。这段等待会直接增加一步训练的耗时,也是分析通信重叠效果时需要统计的部分。
Horovod 的 Tensor Fusion 也处理过小消息过多的问题,它会把一些小张量合并后再发送。DDP 的 bucket 还配合梯度产生的顺序,安排反向计算期间的通信。两者都减少了逐个发送小张量的开销,具体的分组和调度方式有所不同。Horovod 论文,第 7 节
DDP 通过多进程和通信重叠,降低了数据并行的运行开销。随着模型变大,显存开始成为另一项限制:每张卡仍要保存完整参数、梯度和优化器状态。即使再增加几张卡,每个副本需要的这部分显存也不会减少。接下来的 ZeRO 就是从这些重复状态入手。
ZeRO(2019 / 2020,微软)#
微软在 2019 年放出了 ZeRO,2020 年发表于 SC。它的全名是 Zero Redundancy Optimizer,名字里的 Redundancy 指的就是各卡重复保存的训练状态。ZeRO 将这些状态分配给不同的卡保存,减少每张卡的显存占用。
论文报告,在当时的实验条件下,ZeRO 能在不使用模型并行的情况下训练 13B 模型,并与当时 Megatron 的 8.3B、T5 的 11B 规模作了对比。作者希望说明,状态分片也能扩展可训练的模型规模,减少对模型并行改造的依赖。ZeRO 论文摘要
训练显存的组成#
训练显存主要用于保存参数、梯度、优化器状态,这三项合称模型状态。此外还有反向传播需要的激活值、算子工作区和通信 buffer。我们可以先计算模型状态的大小,分析各项分片带来的收益。
假设模型有 个参数,参数和梯度都使用 FP32,优化器采用 Adam,一阶矩和二阶矩也以 FP32 保存。每个参数就需要 字节,模型状态一共占用 字节。
按这个口径,一个 7B 模型的状态就要占约 112 GB,还没算激活值。混合精度训练要根据实际实现重新计算,例如是否保留 FP32 主权重、梯度用什么精度。下面的 GB 均按十进制计算。
为了方便比较,下面用 、、 表示完整参数、梯度和优化器状态的大小, 表示分片组的卡数。
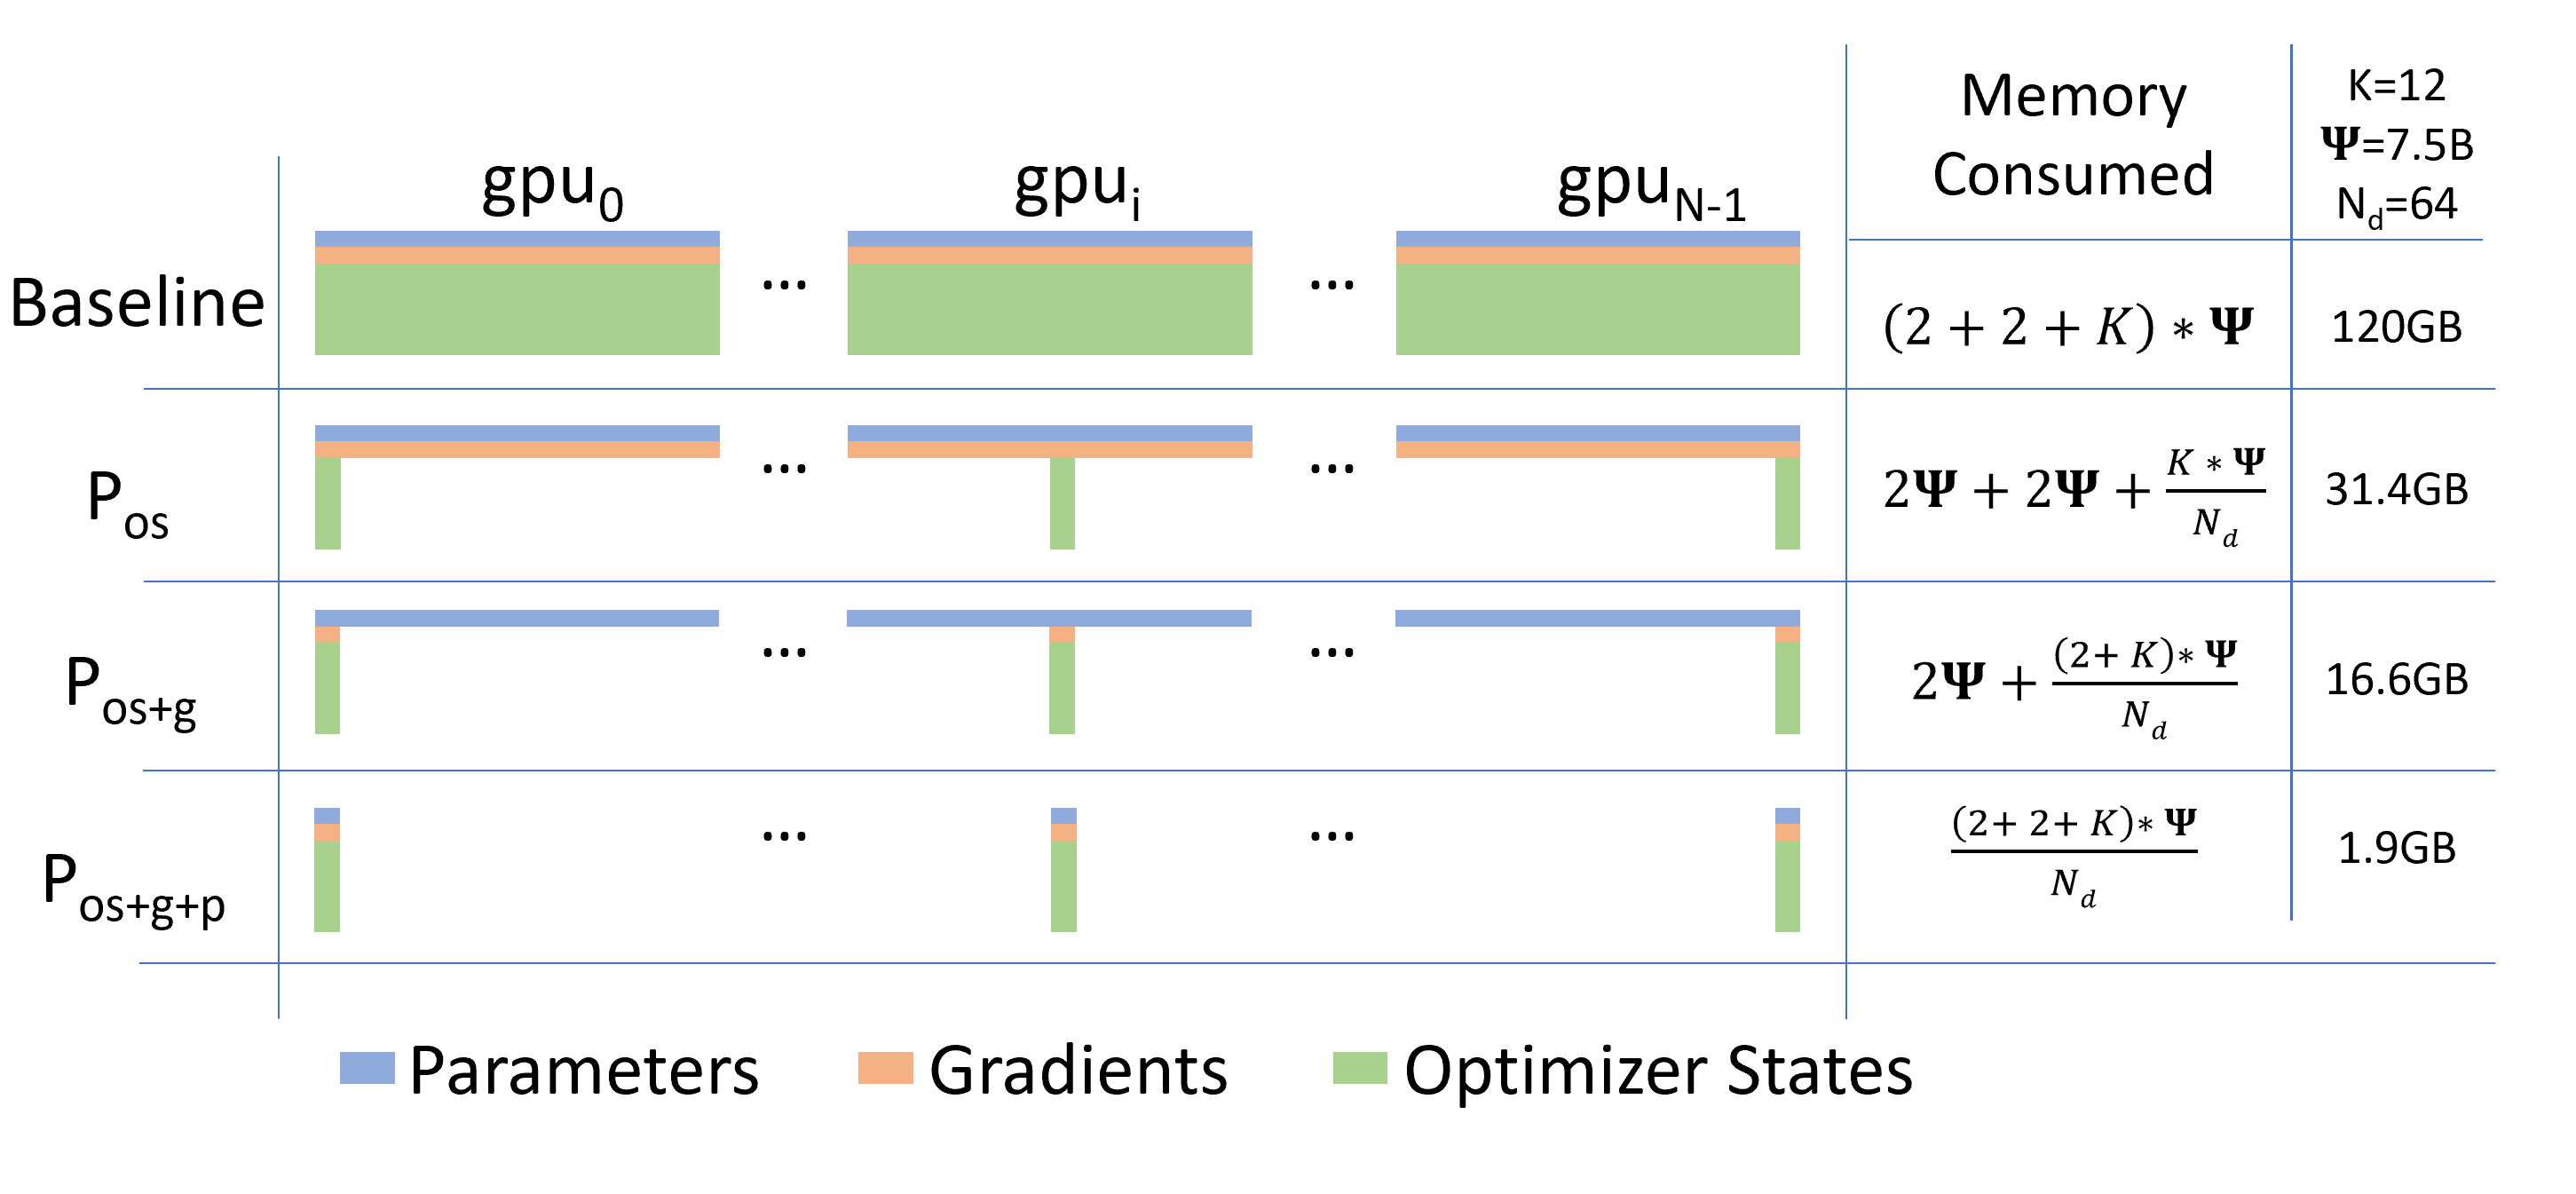
原图按混合精度 Adam 计算,和上面的 FP32 例子口径不同。从上往下看,分别是普通 DP、优化器状态分片、再分片梯度、再分片参数。
ZeRO-1#
Adam 为每个参数维护一阶矩和二阶矩,这些状态只在更新时使用。ZeRO-1 给每张卡分配一部分参数的更新任务,各卡只保留自己负责的优化器状态。前向和反向仍使用完整参数。
更新时,各卡拿到负责部分的归约梯度,更新对应参数,再把更新后的参数分片同步给其他卡。一次更新结束,各卡重新拥有一致的完整权重。
ZeRO-2#
在 ZeRO-1 中,每张卡已经只负责一部分参数的更新,因此长期保存全部梯度也会造成重复占用。ZeRO-2 进一步使用 Reduce-Scatter 归约梯度,让各卡只保留自己负责更新的部分。
我们可以和前面的 Ring All-Reduce 对照来看。普通梯度 All-Reduce 先做 Reduce-Scatter,再用 All-Gather 让各卡得到完整结果;ZeRO-2 的更新任务已经分开,各卡保留对应的归约分片就足够了。计算时仍可能临时产生完整的梯度桶,公式描述的是分片后需要保留的状态。
ZeRO-3#
ZeRO-3 把最后一项完整副本也切开:参数平时只存本地分片,计算某一层或某一组模块之前,再通过通信收集所需的完整参数。
三个阶段减少的存储内容可以列在同一张表中:
| 方案 | 参数 | 梯度 | 优化器状态 | 单卡常驻模型状态 |
|---|---|---|---|---|
| 普通 DDP | 完整 | 完整 | 完整 | |
| ZeRO-1 | 完整 | 完整 | 分片 | |
| ZeRO-2 | 完整 | 分片 | 分片 | |
| ZeRO-3 | 分片 | 分片 | 分片 |
我们继续用前面的 7B 模型,在 4 张卡上采用相同的 FP32 Adam 配置训练。普通 DDP 每张卡需要保存 112 GB 的模型状态,ZeRO-1、ZeRO-2 和 ZeRO-3 则分别降到 70 GB、49 GB 和 28 GB。
ZeRO-3 与张量并行#
ZeRO-3 和张量并行都会把权重分到不同 GPU 上,只看参数保存在哪张卡上,确实容易混淆。我们可以用一个很小的线性层来对比,假设两张卡要处理两条样本,每条样本有两个输入特征,这一层也输出两个特征。
这里采用矩阵乘法 的写法,省略偏置。两条输入分别是 、,权重为
使用 ZeRO-3 时,两条样本分给不同的卡。GPU 0 处理 ,GPU 1 处理 。虽然平时每张卡只保存一半权重,计算这一层之前,两张卡都会先通过 All-Gather 收集完整的 。这样,每张卡都能独立算出自己这条样本的全部输出,分别是 和 。DeepSpeed ZeRO 教程
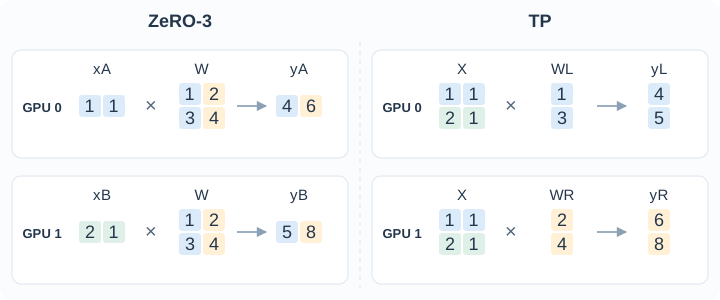
如果采用图中按输出特征切分的张量并行,两张卡会处理相同的两条输入。GPU 0 只保存 的第一列,计算第一个输出特征,得到 4、5;GPU 1 只保存第二列,计算第二个输出特征,得到 6、8。两列拼起来,两条样本的完整输出仍然是 和 。
这样就能看清,ZeRO-3 的参数虽然分片保存,当前层的计算仍由每张卡独立完成;张量并行则让多张卡共同完成这一层的计算。前者在计算前收齐当前层的权重,后者在计算时使用各自的权重分片。Megatron-LM 的线性层切分
实际张量并行还有其他切分方式,输出分片也可以直接交给下一层继续计算,不一定马上拼接。图中的列切分只是为了把区别说明白。ZeRO-3 与张量并行也能组合使用,分别负责数据并行维度的状态分片和模型内部的计算切分。
分片的通信开销#
DDP 的每张卡都有完整参数,前向和反向都可以直接计算,需要在卡间同步的是梯度。按照前面介绍的 Ring All-Reduce,这里有两部分通信:先归约梯度,让各卡拿到自己的那一片结果,再交换这些分片,让每张卡都有完整的平均梯度。
ZeRO-1 和 ZeRO-2 把参数更新分给了不同的卡。按照 ZeRO 论文的通信安排,梯度只需归约到负责更新对应参数的卡上;各卡完成更新后,再交换更新后的参数,恢复完整模型。这样仍然是两部分通信,只是后半段传输的内容从梯度换成了参数。ZeRO-2 比 ZeRO-1 进一步减少了梯度的存储,通信量保持不变。
ZeRO-3 为了节省显存,会在当前层的前向计算结束后,释放刚刚收集的完整参数,只留下本地分片。反向计算输入的梯度时还需要这一层的权重,所以走到这一层时,又要收集一次参数。这样,一步训练就需要前向收集参数、反向收集参数、归约梯度三部分通信。各卡只更新自己负责的参数,梯度归约后保留对应分片就够了。
我们仍用 7B 模型和 4 张卡来算,参数和梯度都以 FP32 传输,各有 28 GB。28 GB 分成 4 片,每片就是 7 GB。采用 Ring 算法时,一次 All-Gather 或 Reduce-Scatter 都需要沿环传递 3 轮,每轮发送一片,所以每张卡发送 GB。把一步训练中各层的传输量加起来,可以得到下面的对照:
| 通信内容 | DDP | ZeRO-1 | ZeRO-2 | ZeRO-3 |
|---|---|---|---|---|
| 前向时收集参数 | — | — | — | 21 GB |
| 反向时收集参数 | — | — | — | 21 GB |
| 归约梯度 | 21 GB | 21 GB | 21 GB | 21 GB |
| 收集完整梯度 | 21 GB | — | — | — |
| 更新后收集参数 | — | 21 GB | 21 GB | — |
| 每步每卡发送量 | 42 GB | 42 GB | 42 GB | 63 GB |
,这就是论文中 ZeRO-3“通信量增加 50%”的来由。ZeRO 论文,第 7 节
实际训练的耗时还要看 GPU 等了多久。前面讲 DDP 时已经看到,一部分通信可以在反向计算的同时完成;ZeRO-3 也可以提前收集下一层的参数,让传输和当前层的计算同时进行。省出的显存还能用来增加每张卡一次处理的样本数,让 GPU 的计算能力有机会更充分地发挥。所以,前面的 1.5 倍用来比较传输量,训练速度则要看相同模型和数据下,每秒实际能处理多少样本。
PyTorch FSDP(2022 / 2023)#
PyTorch 在 2022 年发布了原生 FSDP API,2023 年的 PyTorch FSDP: Experiences on Scaling Fully Sharded Data Parallel 整理了其中的系统设计。完全分片模式和 ZeRO-3 使用同类状态布局,主要工作是把参数收集、梯度归约和显存管理接入 PyTorch 的运行机制。
PyTorch 在发布文章中说明,原生实现大量借鉴了 FairScale 的版本;论文也将 ZeRO 和 cross-replica sharding 列为设计的参考来源。FSDP 在这些工作的基础上,进一步与 PyTorch 的自动求导、通信和内存管理机制配合。
FSDP 的参数生命周期#
假设模型有很多 Transformer block,我们把每个 block 作为一个分片单元。平时每张卡只保留各 block 的参数分片,走到当前 block 时收集完整参数,使用本卡数据完成计算。
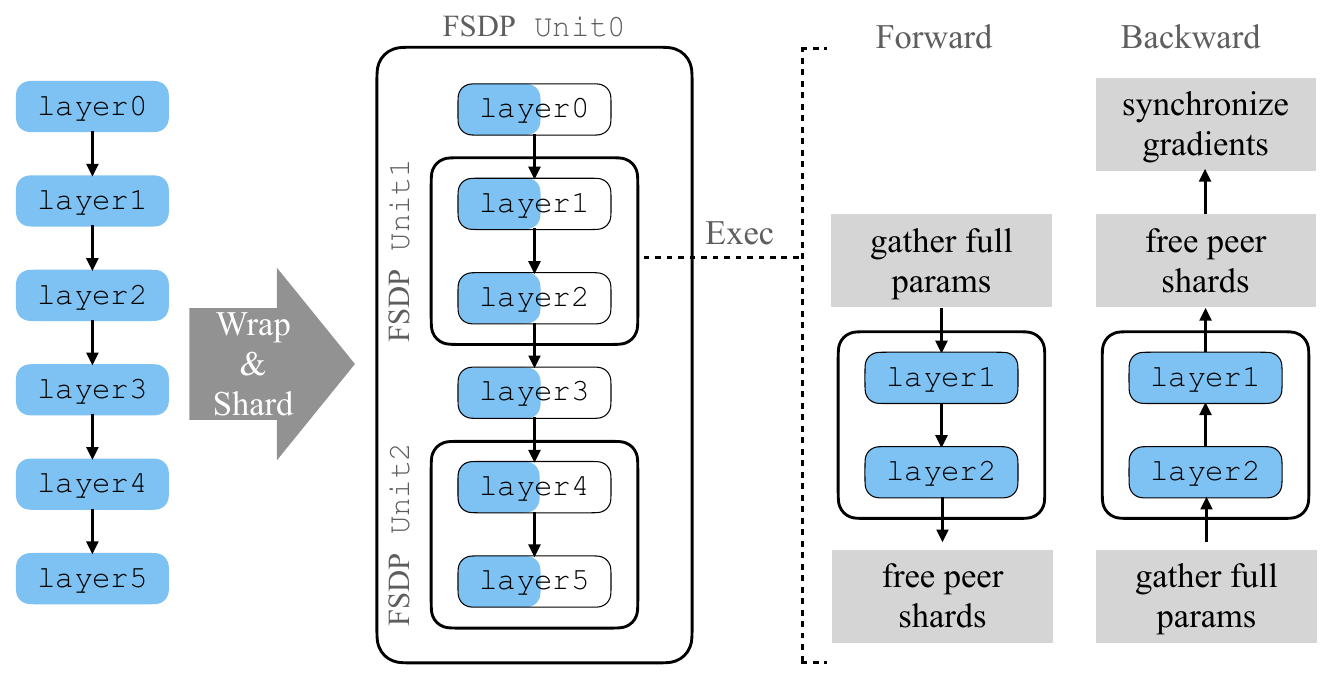
在前向后重新分片的配置下,一个单元的过程如下:
- 前向之前执行 All-Gather,拿到当前单元的完整参数。
- 各卡独立执行前向,保存反向所需的激活,再释放临时完整参数。
- 反向走到这个单元时,再次 All-Gather 参数,计算本地梯度。
- 用 Reduce-Scatter 归约梯度,各卡保留对应分片,释放完整参数。
- 优化器使用分片梯度和分片状态,更新本地参数分片。
常驻模型状态只占峰值显存的一部分,计算时收集的完整参数、激活值和临时 buffer 也会产生额外占用:
分片单元很大,单次收集的参数就多;预取比较积极,又可能让多个单元的完整参数同时存在。因此,迭代结束时的显存占用可能明显低于训练过程中的峰值。
参数合并、预取与限流#
早期 FSDP 会把一个单元内的多个参数展平成 FlatParameter,再统一分片。这样能把很多小张量组织成较大的通信,减少启动开销,也方便管理连续存储。
参数预取则让当前单元计算时,提前收集下一单元的参数。通信和计算有重叠的机会,代价是更多完整参数可能同时驻留。CPU 提交任务又可能快于 GPU 完成任务,持续提前发起 All-Gather,会给内存分配带来额外压力。
FSDP 论文为此讨论了 rate limiter:适当限制在途的参数收集,让缓冲区有机会被回收和复用。CPU 时间线上出现一段等待,并不自动代表 GPU 被浪费了,也可能是在控制后续显存峰值。FSDP 论文,第 3–4 节
HSDP#
大集群里,节点内互联和节点间网络往往差别很大。Hybrid Sharded Data Parallel,HSDP 将分片和复制结合起来,可以把频繁的参数收集限制在较小的高速分片组内。
例如两台机器各有 4 张卡,每台内部构成一个分片组,各卡只存四分之一状态。两台机器中持有相同分片的卡,再沿复制维度同步梯度。每张卡仍然处理自己的数据,所有数据的梯度最终共同决定更新。
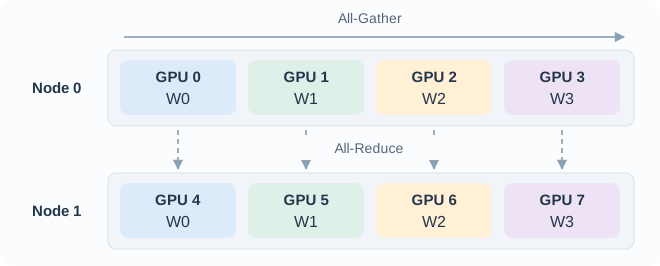
这里单卡常驻模型状态约为完整状态的四分之一,分母是分片组大小 4。复制出第二个组增加了数据并行能力,也保留了第二份模型状态。参数 All-Gather 可以留在节点内,跨节点还需要同步对应的梯度分片。FSDP 混合分片设计
FSDP2 与 DTensor#
早期 FSDP 通过 FlatParameter 管理多个参数,FSDP2 则用 DTensor 分别表示各个参数的全局形状和本地分片。这样,参数原本的名字、形状和分片信息都能保留下来。项目中的 DTensor 教程也会介绍这些布局。
例如某个权重的全局形状为 [4096, 4096],在 4 张卡上沿第 0 维分片,本地一般就是 [1024, 4096]。参数仍有原来的名字和全局形状,布局信息说明这一份张量分布在哪些设备、沿哪一维切分。
这个变化有助于组合张量并行、处理分布式检查点,也让分片参数更容易检查。FSDP2 的入口是 fully_shard,可以直接作用在现有模块上。FSDP2 官方教程
FSDP2 的逐参数表示也保留了通信分组。一次 fully_shard(block) 可以将这个 block 管理的多个参数组成一个通信组,在保留各参数身份的同时,继续通过分组控制收集粒度。fully_shard API
数据并行的新进展#
近年的数据并行研究继续关注编译调度、张量布局和低通信训练。模型结构、优化器和网络条件发生变化后,已有的分片和通信安排也需要相应调整。
SimpleFSDP(2024)#
SimpleFSDP 用 PyTorch 的 parametrization、DTensor 和选择性重计算等机制,让计算和通信更容易进入可编译的图。编译器拿到这些操作后,就有机会做通信合并、重排,以及计算通信重叠。
作者在 TorchTitan 上使用 Llama 3 系列模型验证了这些优化。编译器能够联合调整通信与计算顺序,实际收益也会受到模型规模、其他并行配置和编译效果的影响。
veScale-FSDP(2026,字节跳动)#
2026 年的 veScale-FSDP 把问题进一步放到了块量化和 Muon、Shampoo 一类优化器上。Adam 的主要更新可以逐元素进行,矩阵优化器则可能需要矩阵结构;分片边界如果切碎了计算所需的块,就会增加数据重组和通信。
论文第 2.3 节分析了不同参数布局的开销。作者指出,FSDP2 的逐参数方案需要在通信时打包和拆包数据,而 Megatron-FSDP 采用连接后分片的方式,减少这类复制。论文据此讨论了参数布局对灵活性、内存和通信效率的影响。veScale-FSDP 原文,第 2.3 节
他们提出了 RaggedShard 和结构感知的分片规划,让分片边界尽量对齐计算所需的数据块。以前重点是把参数平均分开,现在还要考虑切在哪里更方便后续计算。
DiLoCo(2023)#
DiLoCo 关注多个连接较弱的计算集群。各个 worker 先独立执行多步本地优化,再通过外层优化器汇总模型变化,减少集群之间的通信频率。
这和 DDP 的梯度累积需要分开看。梯度累积期间参数保持不变,到最后统一更新;DiLoCo 的本地训练已经更新了参数,因此涉及另一套优化过程和收敛验证。它展示了弱互联场景的一条研究路线,是否适合某个模型和训练目标,需要单独评估。
这些工作给出了几条后续方向。高速集群可以继续改进通信重叠和参数布局,新的优化器需要分片边界配合矩阵计算,弱互联集群则需要降低同步频率。数据并行的优化会越来越依赖具体的模型、计算方式和网络条件。
结合项目教程编写代码#
我们可以结合项目里的 DDP、DTensor 和 FSDP 教程,将前面介绍的同步和分片机制对应到代码中。下面的命令都在 dzyy-training 仓库根目录执行,需要项目配置的 PyTorch 环境和至少两张 CUDA GPU。
DDP 的梯度同步#
项目的 tutorial/DP/ddp/01-basic.py 使用两个 MLP,各 rank 生成不同输入,在第一次反向后收集梯度,打印各卡梯度的最大差异。
torchrun --standalone --nproc-per-node=2 tutorial/DP/ddp/01-basic.py这个实验中,各卡的局部 loss 可以不同,同步后的对应梯度应该一致。DDP 自动处理梯度通信,训练数据仍需要单独分配。真实数据集通常配合 DistributedSampler,每个 epoch 通过 sampler.set_epoch(epoch) 设置一致的随机打乱顺序,再由各卡读取不同部分。DistributedSampler 文档
梯度累积与全局 batch#
在前面的例子中,每张卡处理 8 条样本,4 张卡一次共处理 32 条。如果希望一次参数更新使用更多样本,又没有显存增大单卡 batch,就可以使用梯度累积。
梯度累积会在参数不变的情况下,连续进行多次前向和反向,将梯度累加后再更新参数。例如每张卡连续处理 4 批、每批 8 条样本,4 张卡的一次更新就用到了 条样本。
这里,每张卡一次前向处理的 8 条样本称为一个 micro-batch,一次更新使用的全部 128 条样本称为 global batch。将每卡 micro-batch 大小记为 ,累积次数记为 ,数据并行卡数记为 ,就有
项目的 tutorial/DP/ddp/03-accumulation.py 演示了这个过程。前几次反向只累加本地梯度,通过 no_sync() 暂停同步,最后一次再一起归约,随后执行参数更新:
from contextlib import nullcontext
optimizer.zero_grad(set_to_none=True)for micro in range(accum_steps): sync = micro == accum_steps - 1 context = nullcontext() if sync else model.no_sync() with context: # 前向和反向都放在上下文中 x, target = next_batch() loss = loss_fn(model(x), target) / accum_steps loss.backward()optimizer.step()代码里的 loss_fn 返回当前微批的平均 loss。每批大小相同时,各微批的 loss 都除以 accum_steps,再通过反向传播累加,得到的就是整个累积窗口的平均梯度。no_sync() 可以省去中间几次梯度通信,参数和优化器状态仍然完整保留。
比较多卡吞吐时,全局 batch 也会影响结果。例如从 4 张卡增加到 8 张卡,每卡仍然处理 8 条样本、每次都立即更新,全局 batch 就从 32 变成了 64。如果仍保持全局 batch 为 32,每张卡只能分到 4 条样本,本地计算变少,梯度通信的开销就可能更明显。两种设置对应不同的训练负载,需要分别测量。
变长数据的 loss 计算#
上面的平均以各批大小相同为前提。语言模型中的样本经过 padding 后,每张卡的有效 token 数可能不同。如果训练目标是对全部有效 token 求平均,loss 就需要按实际数量加权。
例如 GPU 0 有 100 个有效 token,GPU 1 有 200 个,它们的平均 loss 分别为 和 。全局平均应当是 。直接计算 ,会让前 100 个 token 和后 200 个 token 各占一半权重,偏离原本的训练目标。
实际代码通常先统计有效 token 的损失总和与数量,再统一归一化。由于 DDP 还会对各卡梯度取平均,loss 的缩放也需要配合这一步设置。
DTensor 的布局与通信#
项目的三个 DTensor 教程依次介绍布局、布局转换和自动求导。前两个实验分别对应参数的存储方式和集合通信:
torchrun --standalone --nproc-per-node=2 tutorial/DTensor/00-layout.pytorchrun --standalone --nproc-per-node=2 tutorial/DTensor/01-communication.py00-layout.py 介绍三种 placement:Shard(dim) 沿某一维分片;Replicate() 表示每卡持有相同完整副本;Partial() 表示各卡持有尚未归约的贡献,默认归约操作为求和。DeviceMesh 则描述哪些设备参与,以及这些设备如何组织。
在教程已经初始化好的 mesh 上,下面的代码展示了分片参数的收集和梯度归约,各 rank 会共同执行这些集合通信:
import torchimport torch.distributed as distfrom torch.distributed.tensor import ( DTensor, Partial, Replicate, Shard, distribute_tensor,)
device = torch.device("cuda", torch.cuda.current_device())w = torch.arange(16.0, device=device).reshape(4, 4)sharded = distribute_tensor(w, mesh, [Shard(0)])
print(sharded.shape) # 两张卡上都是 [4, 4]:全局形状print(sharded.to_local().shape) # 每张卡都是 [2, 4]:本地分片full = sharded.redistribute(placements=[Replicate()]) # All-Gather
local_grad = torch.ones(4, 4, device=device) * (dist.get_rank() + 1)partial = DTensor.from_local(local_grad, mesh, [Partial()])grad_shard = partial.redistribute(placements=[Shard(0)]) # Reduce-Scatter对应前面介绍的通信操作,Shard → Replicate 是收集分片,Partial → Shard 是归约后保留分片,Partial → Replicate 则让所有卡拿到完整归约结果。这里的 Partial() 默认求和,训练需要的平均因子要另外处理。DTensor 布局与转换文档
from_local 会按声明的布局解释本地数据,默认不会验证各卡是否满足这个声明。例如 Replicate() 要求各卡表示同一份完整数据,如果各卡输入不同,就不能直接标成复制布局。教程中的 02-autograd.py 让权重分片直接参与矩阵计算,更接近张量并行;FSDP 还需要在模块执行前后安排参数的收集与释放。
FSDP2 的分片粒度#
下面给出一个可以保存为 dp_fsdp_minimal.py 的最小例子。它沿用项目 FSDP 教程的两个 MLP 结构,用 whole 和 layer 两种模式比较分片粒度,省略 profiler,先把初始化到更新的过程串起来。
import osimport sys
import torchimport torch.distributed as distfrom torch import nnfrom torch.distributed.device_mesh import init_device_meshfrom torch.distributed.fsdp import fully_shard
class Model(nn.Module): def __init__(self): super().__init__() self.mlp1 = nn.Sequential( nn.Linear(1024, 4096), nn.ReLU(), nn.Linear(4096, 1024) ) self.mlp2 = nn.Sequential( nn.Linear(1024, 4096), nn.ReLU(), nn.Linear(4096, 1024) )
def forward(self, x): return self.mlp2(self.mlp1(x))
def main(): mode = sys.argv[1] if len(sys.argv) > 1 else "layer" if mode not in ("whole", "layer"): raise ValueError("mode must be whole or layer")
local_rank = int(os.environ["LOCAL_RANK"]) torch.cuda.set_device(local_rank) device = torch.device("cuda", local_rank) dist.init_process_group("nccl") mesh = init_device_mesh("cuda", (dist.get_world_size(),))
torch.manual_seed(42) # 各 rank 从相同参数开始 model = Model().to(device) kwargs = dict(mesh=mesh, reshard_after_forward=True) if mode == "layer": fully_shard(model.mlp1, **kwargs) fully_shard(model.mlp2, **kwargs) fully_shard(model, **kwargs) optimizer = torch.optim.AdamW(model.parameters(), lr=1e-3)
torch.manual_seed(1000 + dist.get_rank()) # 各 rank 使用不同数据 x = torch.randn(8, 1024, device=device) for _ in range(3): optimizer.zero_grad(set_to_none=True) loss = model(x).square().mean() loss.backward() optimizer.step()
for name, param in model.named_parameters(): print(dist.get_rank(), name, param.shape, param.to_local().shape, param.placements) break dist.destroy_process_group()
if __name__ == "__main__": main()torchrun --standalone --nproc-per-node=2 dp_fsdp_minimal.py wholetorchrun --standalone --nproc-per-node=2 dp_fsdp_minimal.py layer这里先对内部模块调用 fully_shard,再处理外层模型,最后创建优化器。外层只接管尚未被内部调用管理的参数;这个模型的参数全在两个 MLP 里,layer 模式下根模块不会额外收集一遍两个 MLP 的参数。
示例显式设了 reshard_after_forward=True,让两种模式都在前向后释放完整参数。FSDP2 对根模块有特殊的默认处理,做实验时把这个选项写明,才能把观察重点放在分片粒度上。
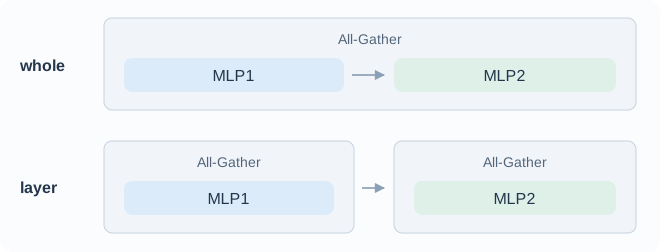
对这个固定结构、单精度且每个单元只执行一次的例子,逻辑通信次数可以预先列出来:
| 模式 | 参数管理单元 | 每次迭代 All-Gather | 每次迭代 Reduce-Scatter |
|---|---|---|---|
whole | 整个模型 | 2 次:前向、反向各一次 | 1 次 |
layer | 两个 MLP 各自管理 | 4 次:每个 MLP 各两次 | 2 次 |
逐模块分片让一次需要收集的完整参数更少,也提供了计算通信重叠的机会,通信启动次数随之增多。预取时多个单元仍可能同时驻留,所以“单元更小”不等于峰值严格按同样比例下降。这里统计的是逻辑集合通信,底层 kernel 数量和名称要以实际 trace 为准。
项目里的 tutorial/DP/fsdp/01-fsdp.py 加上了预热、阶段标记和每个 rank 的 profiler 导出,可以用相同的 whole、layer 参数继续观察。导出的 trace 能显示 All-Gather、Reduce-Scatter 和模型计算的执行顺序,也能用于分析它们的重叠时间。
实际 Transformer 可以先从 block 粒度开始,再根据显存和步时调整。初始化大模型时还要避免在分片前就把完整模型放进单卡,示例这种“先整体 .to(device)”只适合本身能容纳的小模型;大模型需要配合 meta 初始化、分片加载等路径。FSDP2 初始化教程
HSDP 则可以用二维 mesh 表达。以下是前面“两台机器各四卡”布局的配置片段,要求先按对应的 8 进程环境初始化通信,rank 排布和机器拓扑一致:
mesh = init_device_mesh( "cuda", (2, 4), mesh_dim_names=("dp_replicate", "dp_shard"))for block in model.blocks: fully_shard(block, mesh=mesh)fully_shard(model, mesh=mesh)项目中的 dzyy_training/distributed/fsdp_parallel/fsdp.py 使用的也是这类方式:取出 dp_replicate 和 dp_shard 组成的 mesh,先处理各 block,再处理外层模型。其中 dp_shard 对应分片组,dp_replicate 对应分片组之间的复制。
实际训练中的选择#
如果模型状态能完整放进单卡,DDP 可以作为性能基线,用来测量每卡处理的样本数和梯度通信对吞吐的影响。优化器状态或梯度占用过大时,可以采用相应的状态分片;完整参数也难以常驻时,则需要完全分片,并评估收集参数时的显存峰值。
跨节点网络较慢,可以测 HSDP,比较减少参数收集参与者之后的步时和额外状态副本。显存仍然紧张时,还可以结合激活重计算或其他并行方式。
做对比时,模型、序列长度、全局 batch、精度、激活重计算和梯度累积口径需要对齐,再同时看吞吐、步时、峰值显存与 loss。我们在四卡实测效果里继续看这些配置放到同一台机器上之后的表现。
论文与原始资料#
上文涉及的设计、实验和开发经历,都可以在以下论文、官方文档和发布文章中找到。
- Dean 等,2012:Large Scale Distributed Deep Networks。
- Uber,2017:Horovod 发布文章;Sergeev、Del Balso,2018:Horovod 论文。
- Paszke 等,2019:PyTorch 设计论文;Li 等,2020:PyTorch Distributed / DDP。
- Rajbhandari 等,2019 / 2020:ZeRO;DeepSpeed ZeRO 教程。
- PyTorch,2022:FSDP 发布文章;Zhao 等,2023:FSDP 论文。
- FSDP2 教程、
fully_shardAPI、DTensor API。 - Zhang 等,2024:SimpleFSDP。
- Wang 等,2026:veScale-FSDP。
- Douillard 等,2023:DiLoCo。