
4 卡真实性能对比:DP / TP / PP / CP
在同一台四卡机器与统一负载下比较吞吐、步时和峰值显存。
同一台 4×H100 PCIe 机器上,数据并行、张量并行、流水线并行和上下文并行各自最快的版本,在 Qwen3 0.6B、1.7B、7B 上能跑多快、占多少显存。所有数字来自同一负载、三次独立重复;原始记录在 benchmarks/runs/2026-10-29-perf-final/。
结论#
| 规模 | 指标 | DP | TP | PP | CP |
|---|---|---|---|---|---|
| 0.6B | 吞吐 (token/s) | 55,692 | 5,902 | 69,892 | 17,428 |
| 0.6B | 步时 (s) | 0.588 | 5.552 | 0.469 | 1.880 |
| 0.6B | 峰值 (GiB) | 34.5 | 12.0 | 14.7 | 16.4 |
| 1.7B | 吞吐 (token/s) | 20,749 | 2,829 | 43,295 | 10,255 |
| 1.7B | 步时 (s) | 1.579 | 11.583 | 0.757 | 3.195 |
| 1.7B | 峰值 (GiB) | 51.7 | 13.8 | 21.4 | 33.3 |
| 7B | 吞吐 (token/s) | 1,185 | 1,222 | 15,724 | 2,087 |
| 7B | 步时 (s) | 27.646 | 26.813 | 2.084 | 15.700 |
| 7B | 峰值 (GiB) | 57.0 | 38.6 | 56.3 | 58.6 |
PP 在三个规模上都给出最高吞吐:0.6B 69.9k、1.7B 43.3k、7B 15.7k token/s。DP 在 0.6B 和 1.7B 次之(55.7k / 20.8k),7B 换成 FSDP2 四路后掉到 1.2k。CP 在 0.6B/1.7B 高于 TP,7B 的 CP2×TP2 为 2.1k,反超 DP 与 TP。TP 在 0.6B/1.7B 吞吐最低,7B 时略高于 DP;它的显存始终最省。
实验设置#
| 项 | 设置 |
|---|---|
| 硬件 | 4 × H100 PCIe 80GB,设备 1–4;两对 NVLink,跨对 PCIe |
| 模型 | Qwen3 0.6B / 1.7B / 7B(7B preset 实际 6.80B 参数) |
| 负载 | 序列 2048;每步全局 32,768 个有效 token |
| 数据 | WikiText,qwen3 分词;固定 seed |
| 精度 | bf16 autocast;参数与梯度 fp32;7B 的 DP/CP 把 Adam 状态存成 bf16 以放进 80GB |
| 计时 | 0.6B/1.7B:warmup 5 + 计时 12 步;7B:warmup 2 + 计时 6 步;每个配置 3 次独立进程,取中位数 |
| 显存 | torch.cuda.max_memory_allocated() 的进程峰值,跨卡取最大 |
每个并行轴先在自己的候选集合里选最快版本:DP 比较 DDP、FSDP2 与 HSDP 2×2;TP 比较 eager / compile(不使用 TP-SP);PP 比较 1F1B、交错与 Zero-Bubble;CP 比较 Ulysses 与 USP。候选记录在 benchmarks/runs/2026-10-29-perf-screen/,最终入选版本如下:
| 规模 | 数据并行 | 张量并行 | 流水线并行 | 上下文并行 |
|---|---|---|---|---|
| 0.6B | DDP + compile | TP + compile | 1F1B + compile | Ulysses + compile |
| 1.7B | DDP + compile | TP + compile | 1F1B + compile | Ulysses + compile |
| 7B | FSDP2 4 路 + eager + AC + bf16 states | TP + eager | 1F1B + compile | CP2×TP2 + eager + AC + bf16 states |
候选里还包括 FSDP2 四路、TP 的 compile-graph、PP 的交错调度与 Zero-Bubble、CP 的 USP;只有最终入选版本进入 3 次重复矩阵。7B 的纯 DDP 与纯 CP 都放不下完整 fp32 状态,分别改用 FSDP2 四路与 CP2×TP2。
CP 只切序列,不切参数和优化器状态。7B 的纯 CP 在单卡放不下完整的 fp32 状态(参数、梯度、Adam 合计约 108 GB),因此 7B 的 CP 数据使用 CP=2 × TP=2,把 4 张卡都用上,并开启 activation checkpoint 与 bf16 优化器状态;图中标注为 CP。0.6B 与 1.7B 使用纯 CP。DP 在 7B 上也用 FSDP2 四路分片 + activation checkpoint + bf16 优化器状态;HSDP 2×2 单步更快,但 6 步长跑会在 80 GiB 附近碎片化 OOM,未入选。
三张图的纵轴分别是:集群吞吐(每步 32,768 token ÷ 步时)、步时(秒/更新)和进程峰值显存(GiB)。误差条是 3 次独立重复的最小–最大范围。
吞吐#
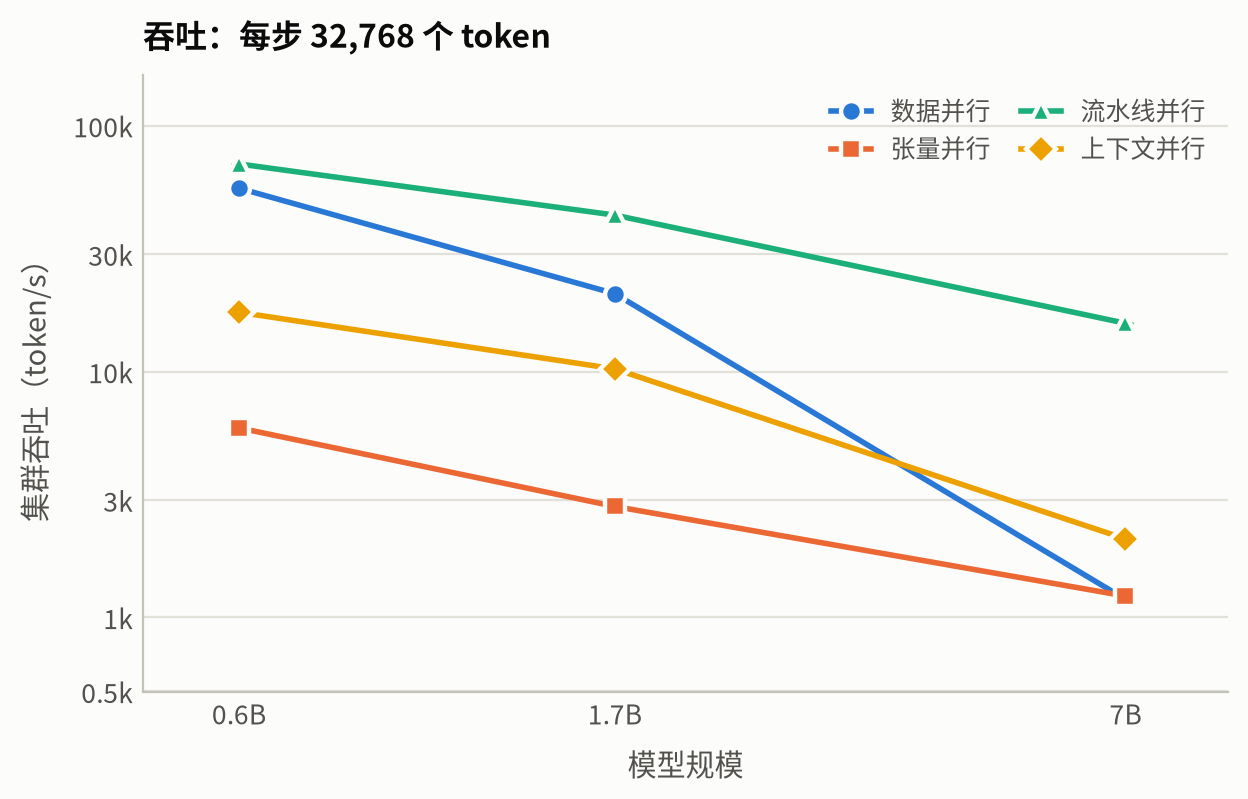
0.6B 的排序是 PP 69.9k > DP 55.7k > CP 17.4k > TP 5.9k;1.7B 是 PP 43.3k > DP 20.8k > CP 10.3k > TP 2.8k;7B 是 PP 15.7k > CP 2.1k > TP 1.2k ≈ DP 1.2k。PP 在 7B 领先 CP 约 7.5 倍、领先 TP 约 12.9 倍、领先 DP 约 13.3 倍。
DP 的曲线在 7B 断掉:前两个规模还能保持 55.7k/20.8k,7B 的 DDP 放不下完整状态,改用 FSDP2 四路 + 重算 + bf16 状态后只剩 1.2k。CP 的下降更缓:0.6B/1.7B 的 Ulysses 受 all-to-all 限制,7B 的 CP2×TP2 反而比 DP/TP 高。
延迟#
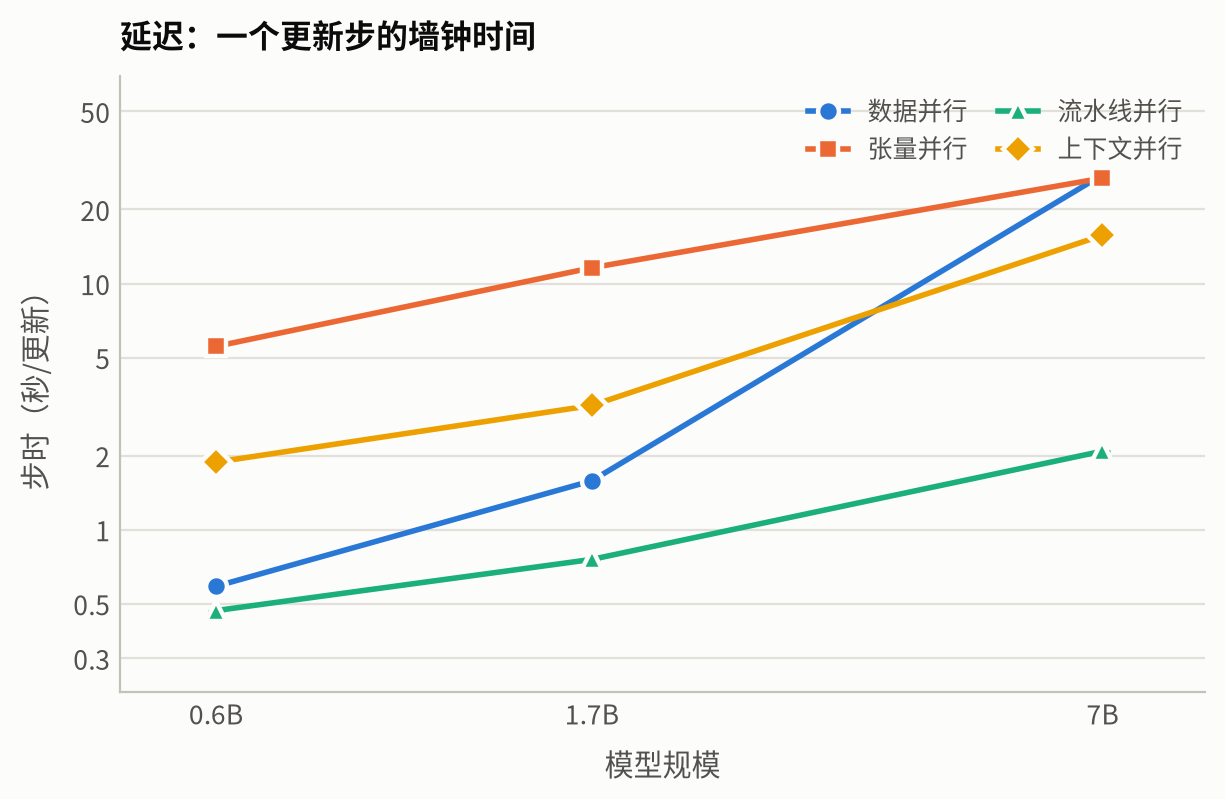
PP 的步时是 0.469 → 0.757 → 2.084 s;DP 是 0.588 → 1.579 → 27.646 s;CP 是 1.880 → 3.195 → 15.700 s;TP 是 5.552 → 11.583 → 26.813 s。同一份 32,768 token 的活,7B 的 PP 只要 2.1 s,CP 要 15.7 s,TP 要 26.8 s、DP 要 27.6 s。
从 0.6B 到 7B,PP 的步时只涨 4.4 倍,CP 涨 8.4 倍,TP 涨 4.8 倍;DP 的涨幅最大(47.0 倍)。这正是跨对通信的代价:PP 只传段间激活,DP 的分片集合通信随模型状态增长,CP 的 All-to-All 随激活增长;7B 的 DP 与 CP 都换了策略,涨幅里包含策略变化。
显存#
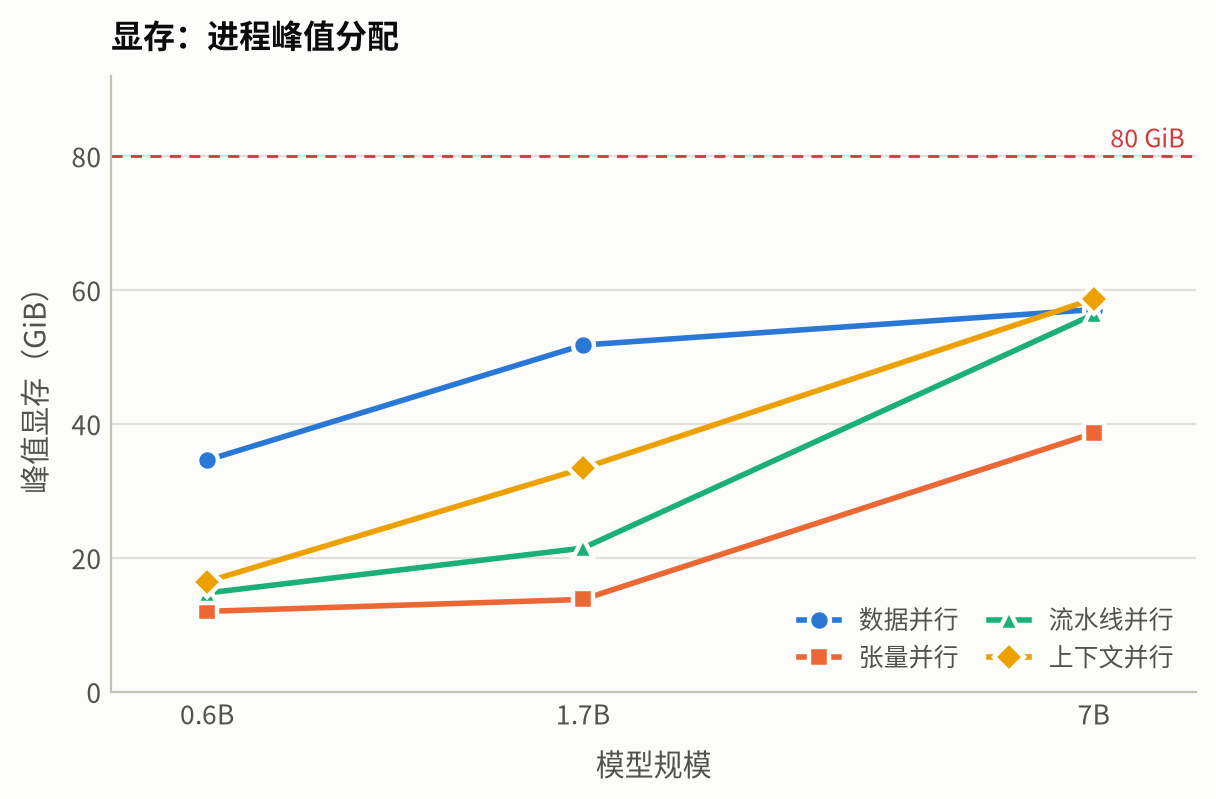
TP 的峰值是 12.0 / 13.8 / 38.6 GiB,三个规模都最省;PP 是 14.7 / 21.4 / 56.3;CP 是 16.4 / 33.3 / 58.6;DP 是 34.5 / 51.7 / 57.0。0.6B/1.7B 的排序是 TP < PP < CP < DP;7B 变成 TP 最省,PP/DP/CP 都挤在 56–59 GiB。按 allocated 峰值算,离 80 GiB 上限还有 21–24 GiB;nvidia-smi 的 reserved 更高,7B 的 DP 长跑时约 71 GiB,实际余量只有约 9 GiB。
7B 的 DP/CP 都开了 activation checkpoint,并把 Adam 状态存成 bf16;PP/TP 没开。所以这张图比较的是“能让 7B 在 4×80GB 上跑起来的最快版本”,不是同一套重算开关下的纯算法对比。
怎么读#
- 流水线并行在这台机器上最快。 段间只传激活,跨对 PCIe 的代价远小于 DP 的梯度同步或分片 All-Gather,也小于 TP 的逐层 All-Reduce;7B 的差距最大。
- 数据并行只在中小模型有竞争力。 DDP 的每卡状态是完整模型,1.7B 仍放得下;7B 必须分片,4 路 FSDP2 的跨对 All-Gather 很贵,再叠加 activation checkpoint 和 bf16 状态才放进 80GB。HSDP 2×2 单步更快,但长跑会在显存上限附近 OOM。
- 张量并行的价值是省显存,不是吞吐。 4 卡 TP 每层一次 All-Reduce,跨对 PCIe 的固定延迟把步时拖长;compile 在 4 卡上的收益远小于 2 卡,7B 的 compile 甚至更慢。
- 上下文并行只切序列。 2048 的序列切成 512 后,Ulysses 的 All-to-All 仍要跨对;0.6B/1.7B 的吞吐高于 TP、低于 DP/PP,7B 的 CP2×TP2 反超 DP 与 TP。7B 纯 CP 放不下;CP2×TP2 才能提供 4 卡数据,CP2×FSDP2 的跨对 All-Gather 更慢,未入选。
- 显存排序与吞吐不同。 TP 最省,PP 次之;DP 与 CP 取决于是否分片,7B 的 DP/CP 靠重算与 bf16 状态压进 80GB。
复现#
最终矩阵的完整脚本是 benchmarks/runs/2026-10-29-perf-final/run.sh。它按 DP、TP、PP、CP 的顺序启动各格;每格 3 次独立进程。7B 的 DP 格额外设了 PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True,其余格没有。候选版本与筛选记录在 benchmarks/runs/2026-10-29-perf-screen/;7B 的 DP/CP 组合在最终目录里留有试跑记录。
单格示例:
CARDS=4 PRESET=0.6b CASES=ddp MODES=compile BATCH=4 ACCUM=4 \ STEPS=12 WARMUP=5 REPEAT_EAGER=3 REPEAT_OTHER=3 \ bash benchmarks/data/run.sh三张图由一次性的 matplotlib 脚本从最终 JSON 生成,绘图脚本没有入库;数值以 JSON 为准。
边界#
- 只测 4 卡、单机。7B 的 DP 与 CP 为了放进 80GB,分别使用 FSDP2 四路 + bf16 优化器状态 + activation checkpoint 和 CP2×TP2 + bf16 优化器状态 + activation checkpoint,图中已标注;它们不是纯 DDP/纯 CP 的数字。
- 机器是两对 NVLink 加跨对 PCIe。结论不能外推到全 NVLink 或更多卡;链路拓扑本身就是一个变量。
- TP 的
compile-graph在 4 卡上没有完成(7B 捕获挂起),因此 TP 统一比较compile与eager;这不是“compile 对 TP 无效”的结论。 - 序列固定为 2048。CP 的价值在更长序列;本文不覆盖长上下文扫描。
- 7B 的 DP 与 CP 最终只跑了 eager;这两格的 compile 没有进入候选矩阵,不能断言 compile 在 7B 上不会更快。
- 每个配置重复 3 次,只能降低、不能消除多用户机器的背景噪声。小于约 2% 的差异不要单独解读。