
流水线并行:从 GPipe 到 1F1B 与 Zero Bubble
围绕切层、微批、气泡和激活生命周期理解流水线调度。
流水线并行在训练中的位置#
大模型训练把一张卡放不下的东西分到多张卡上。
关于并行之前我们提过,分为两个大类:
- 数据并行,包括DP系列和CP系列
- 模型并行,包括TP系列和PP系列
| 并行轴 | 切分对象 | 每卡保留 | 主要通信 | 对激活显存的影响 |
|---|---|---|---|---|
| 数据并行 DP | 样本 | 完整模型状态 | 梯度 All-Reduce | 固定全局批次时随 DP 增大而降低 |
| 张量并行 TP | 权重矩阵 | 每层权重分片 | 每层 All-Reduce/All-Gather | 降低,配合序列并行更明显 |
| 序列并行 CP | 序列 | 序列分片 | 注意力 K/V 交换 | 降低 |
| 流水线并行 PP | 层 | 每段层 | 段间边界激活 P2P | 基本不变 |
PipeDream 2018年 微软#
在当时,绝大部分多卡并行方法叫做数据并行,也就是把模型放在好几个机器里,然后把数据切分到不同的机器上进行计算。但是发展到后来,模型越来越大,单卡根本放不下模型,因此就产生了一些针对模型的并行方案。 例如张量并行还有按照层切分的并行。
但是这两个方法普遍都有问题,要不就通信开销太大(张量并行),要不就资源闲置(有数据依赖)。 因此PipeDream提出了两个核心机制:
- Aggressive Pipelining
- Perfect Overlap
在当年的论文用词都比较激进hh,与此同时这里要注意的是,它主要解决的还是 DNN 模型。
首先,和处理器的流水线一样,它先把DNN切分若干块,每个块在不同的机器节点上执行。并且它提出了一种简单的负载均衡机制(训练前做一个profiling)确定如何划分DNN的层,例如有的机器多分一些,有的少分一些等等来最小化通信。
其次,它把前向和反向的批次交织在一起,确保在反向传播时经过相同的节点,有助于保持节点忙碌。并且还提出了管理权重的方案,因为不同的设备可能速度不一致,假设设备0是第10个批次,设备3是第8个,当设备3回传的时候,就会用旧的参数去更新新的参数,因此它的解决方案是——全都存下来!
这个图展示了4台流水线是如何并行分配的,并且重点展示了计算和通信之间的重叠。 它的切分逻辑在最上边,神经网络按照层来切分。下边的虚线框表示任何一台机器运行时候的时间轴。
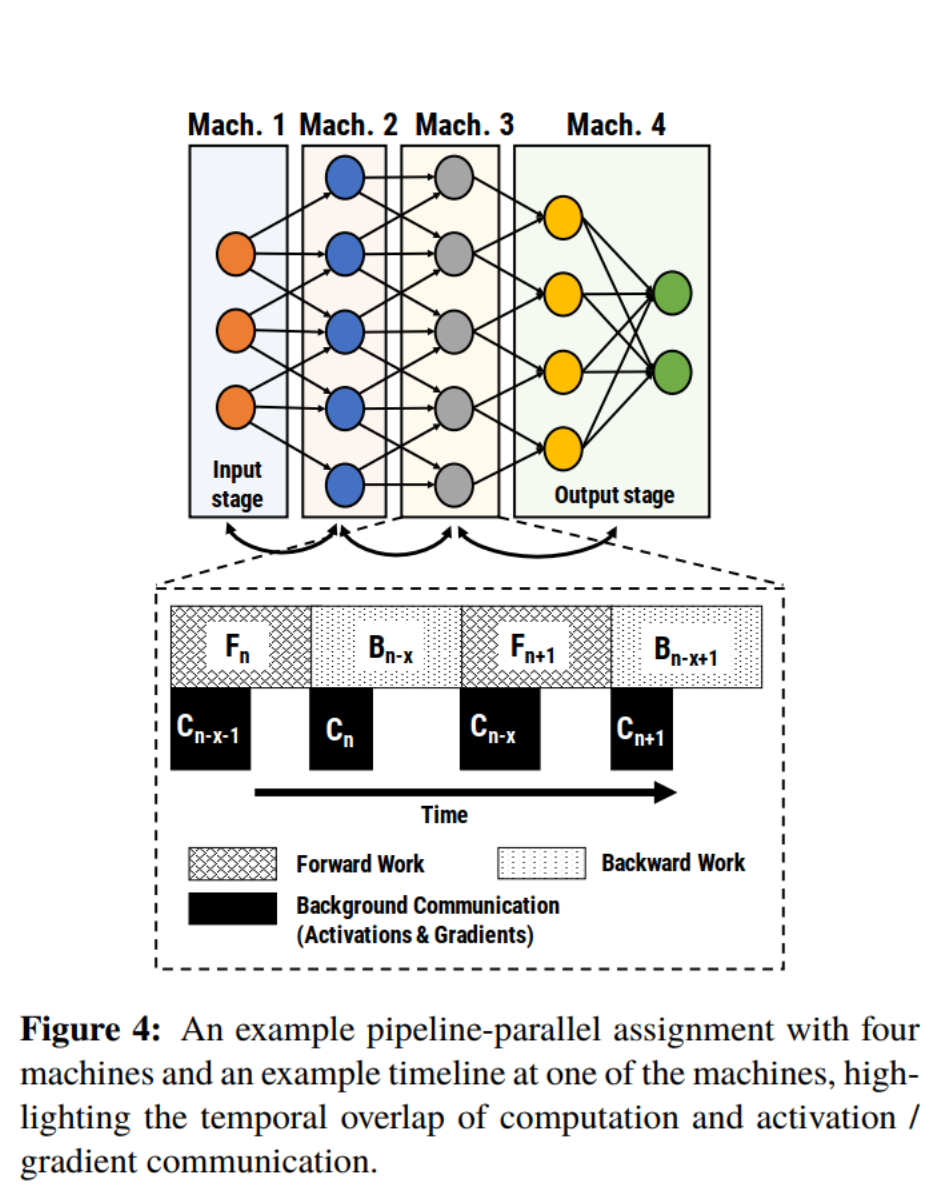
在这个时间轴中,可以看到PipeDream把通信和计算结合在一起。 这也是未来1F1B调度方案的雏形。
仔细看这里的F和B,他们分别代表Forward和Backward。 在一台机器中,F和B交替执行,例如刚刚算完某一个批次的F,就紧接着算之前某个批次的B。
在后续的文章GPipe中,机器必须等待所有的F算完再去算B,中间就会产生气泡,而这篇文章通过这种交错,让机器一直处于一种忙碌状态。
注意,这里的F和B的下标不一样,表明PipeDream是异步更新的,因此就会产生【权重过时】的问题。
除此之外,它还进一步把流水线并行和数据并行、张量并行结合起来,这样子整体的机器效率就会更高(不过这并不是这篇文章的重点。)
下边这个图就展示了他们的时序效果,可以看出只有最初的模块会有一些气泡,之后效率就会相对来说比较高。
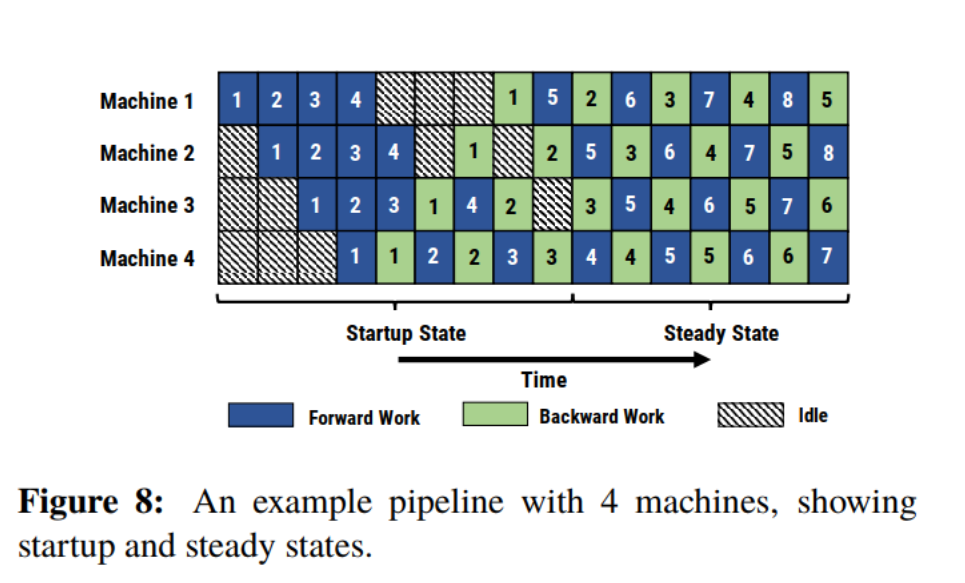
那么问题来了,代价呢? 我们再来看看GPipe是如何批判然后进行解决的?
GPipe 2018年#
在当时,很多模型并行算法是架构特定和任务特定的,当时的GPU间通信发展的还没有那么快,因此存在一些问题。论文中提到了两个方法:SPMD和PipeDream。
其中SPMD的核心概念就是张量并行等等,例如把矩阵乘放在不同的设备上,最终汇总。优点是模型参数可以随着设备数量线性增长,但是它的通信开销极大。每一步都要all-reduce,只能跑在高速网络上,并且对模型算子也有非常大的限制。例如矩阵乘就比较方便,但是卷积计算就很难高效切分。
另外一个叫做PipeDream,它是选择把前向传播和反向传播交织在一起跑(后续也会提到)。但是它是异步更新的,就会导致反向传播算梯度的时候,用的可能就是过时的模型参数。那当时为了缓解这个问题,PipeDream就让每张卡存了好几份模型参数,直接导致显存爆炸,很难训练更大的模型。
GPipe 流水线并行的核心特点,原文如下:
With the growing number of applications of deep learning, there is an ever-increasing demand for reliable and flexible infrastructure that allows researchers to easily scale neural networks for a large variety of machine learning tasks.
可以看到,GPipe的核心特点是可靠性和可扩展性。它允许扩展任意深度的神经网络,可以在不同的加速器之间划分模型来减少单个模型的通信开销。
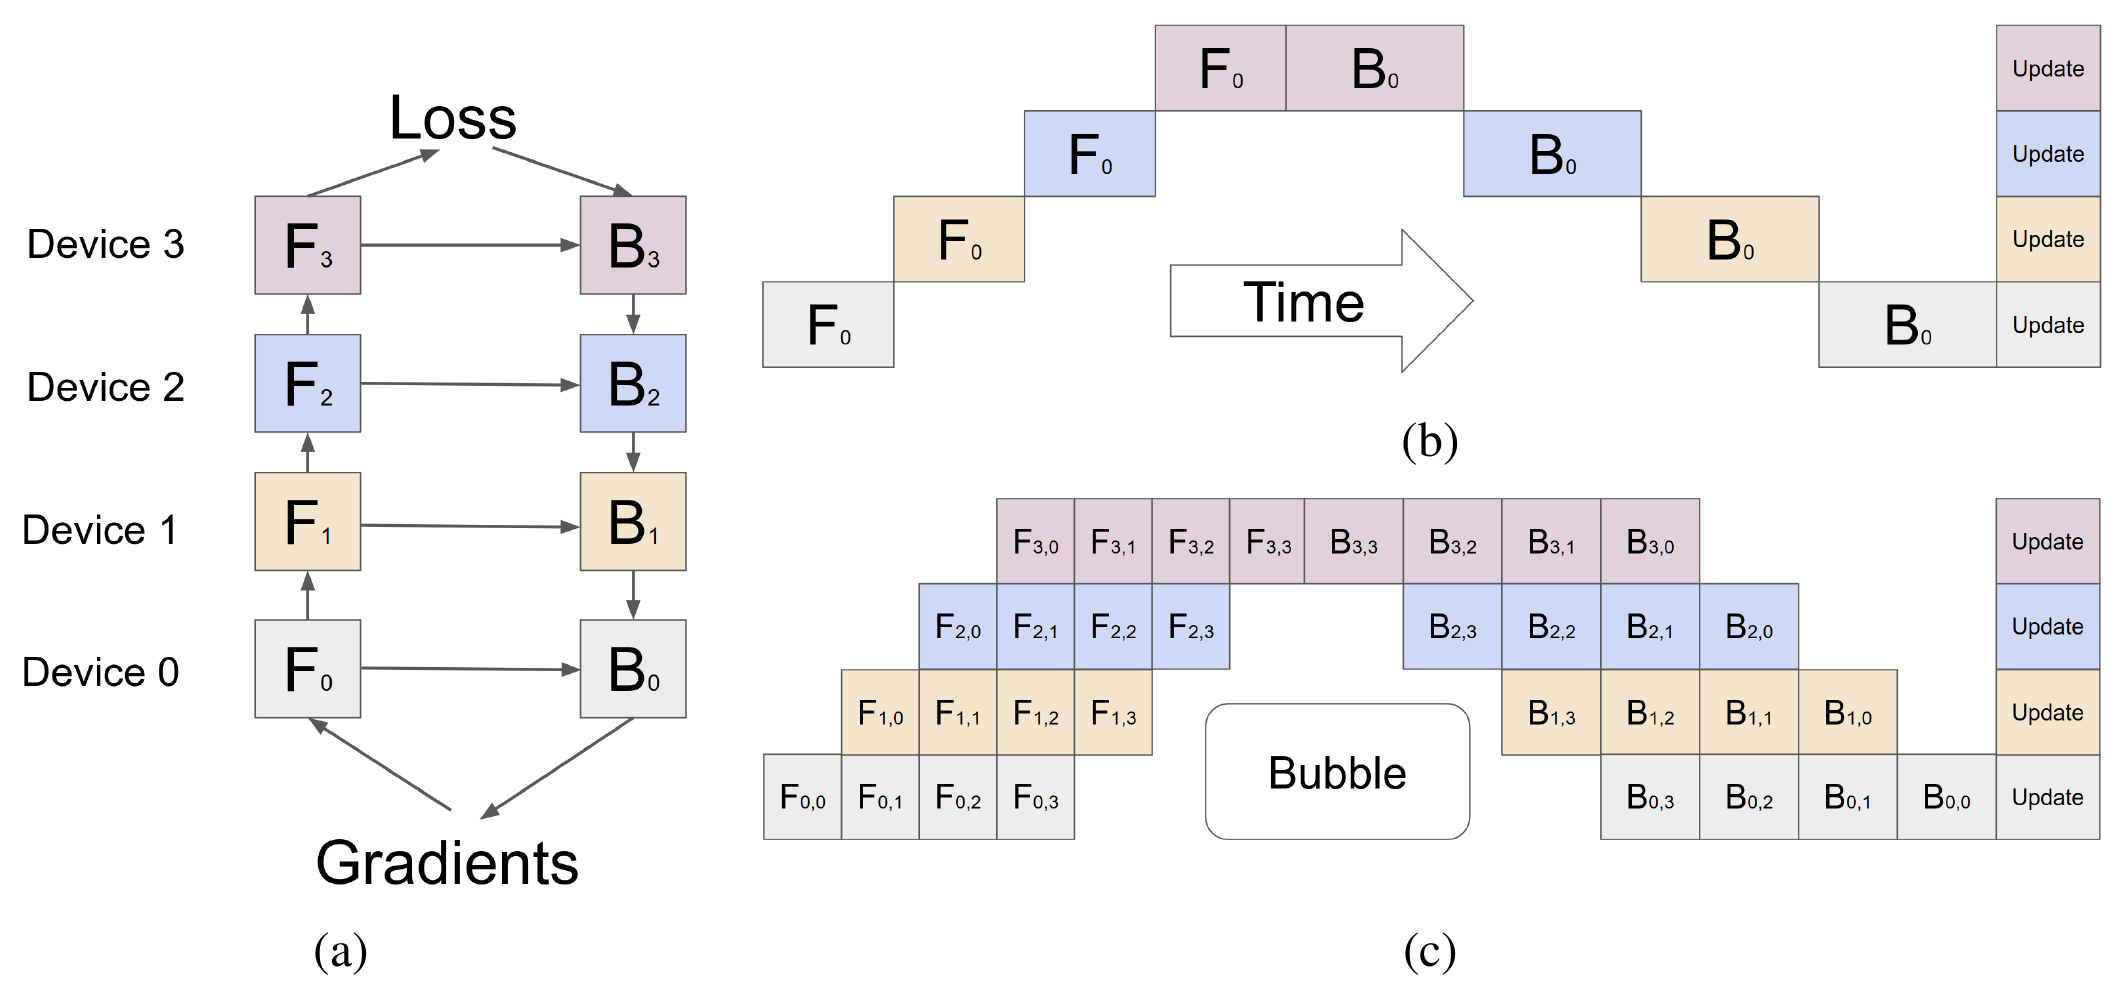
图 1 GPipe 论文(arXiv:1811.06965,Figure 2)。(a) 四段切分下的前向依赖;(b) 不使用微批时各段串行,利用率极低;(c) 引入微批后不同段同时处理不同微批,梯度在末尾统一施加。
GPipe的核心思想主要在于把原本的一个批次拆分为更小的批次。 假设我们现在有4层,单张显卡放不下,因此需要放到4个不同的设备上。
先看左图,对于前向传播,数据从下向上走。一直到Device3算出loss。 之后梯度从上向下走,需要注意的是,反向传播的时候,不仅依赖于上一层的B,还依赖同一层的F。
那为什么要提出GPipe呢?请看图b。 横轴代表时间,在图b中,竖着切一刀,会发现任何一个时刻,只有1个设备在干活。这是因为设备之间有严格的顺序依赖。Device1必须等Device0算完F0才能算F1,以此类推。
这样的后果是任意一个时刻,尽管有N台设备,但是只有1台设备实际在工作,利用率严重不足,极大地浪费算力。
而GPipe的解法也很简单,它把原本的一个大的Batch切分成为了更小的批次。 例如在时间点3,同时会有F20,F11,F02在工作,相比较原本的方案来说,尽管仍然会有一些等待,但是此时利用率已经有一定量的提升。
当所有的micro-batch流到最后,统一进行Update。
相比较原本的单个设备,现在的GPipe多了一些参数,也就是图中的参数。
- 如何切分模型权重
- 如何切分批次
这两个点就是核心的点。
那么在实际情况下,例如我假设现在有一张5090和一张5070,可能5090计算效率高一些,5070计算效率低一些,此时就可以动态调整模型权重,例如90多放几层,70少放几层,可以实现他们的整体计算效率都是均衡的等等。
下边这个表就是GPipe的核心实验证明。 Naive表示传统的方式,也就是直接在单张卡上进行训练。 Pipeline-K表示把模型切分成为多少份,例如Pipeline-8就是把模型放在8个加速器上训练。
其中它主要使用了两个架构,分别是AmoebaNet和Transformer,一个针对传统的CNN,另一个针对Transformer。 并且还展示了整个权重、峰值激活权重等等。
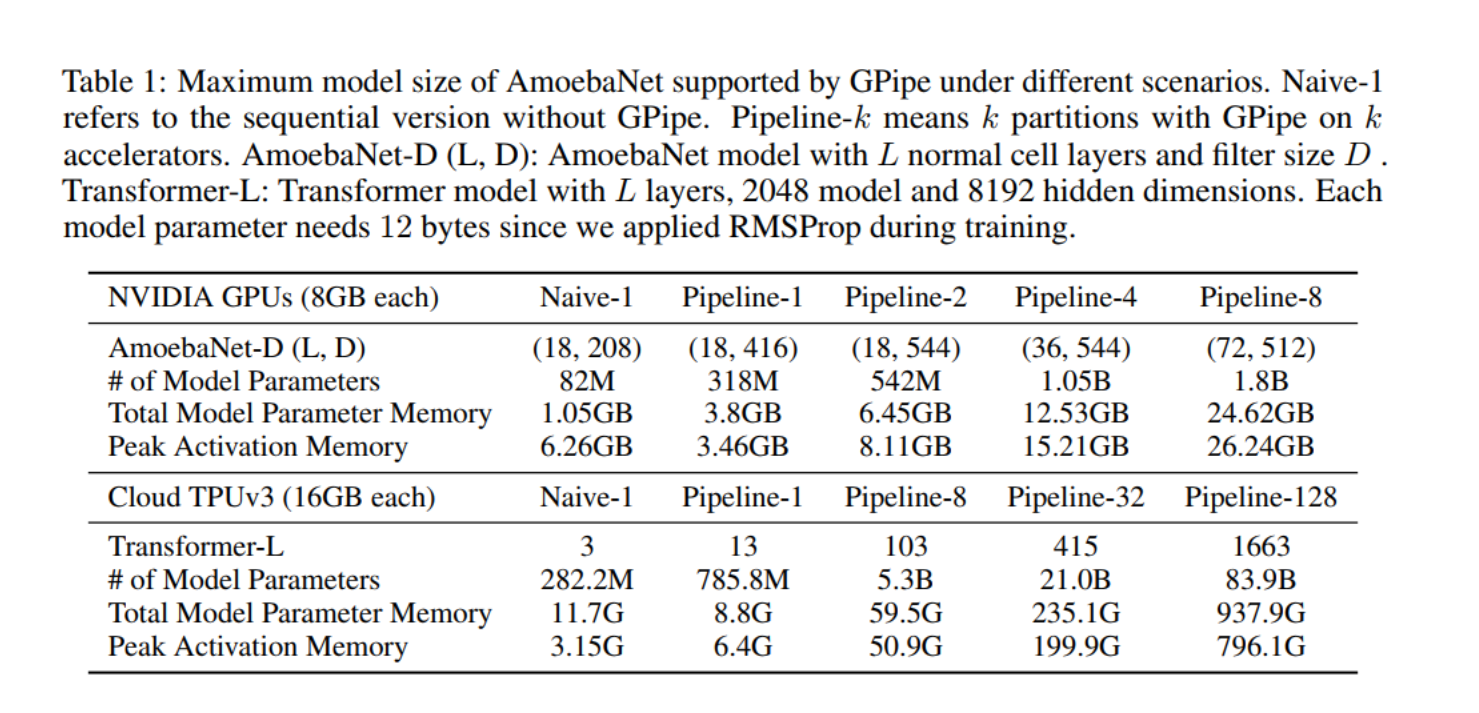
假设你现在用的是一张8G显存的显卡,在传统的单卡中,你最多只能训练一个82M的、18层的CNN模型。 尽管这个时候模型参数只有1G附近,但是峰值激活内存在6G附近,很容易OOM。
假设现在使用PipeLine-1,那它和单卡的区别就在于把Mini-batch切分成为了Micro-batch,峰值激活内存从6G减少到了3G。(这里我觉得只是单纯的把批次变小)
进一步来看pipeline-8,此时能够训练的模型规模已经达到了1.8B,层数也到了72层。其中模型参数是24G,平均每张卡3G左右,激活内存是26G,刚好可以放到8张卡里。
表格下边进一步在TPU上也做了相关的测试,最终可以看到假设有128张TPU,甚至可以训练83B的模型。
这个方法的显著优点就是它具有非常强的扩展性,并且和硬件解耦合,和模型解耦合,只要是它符合这种层级结构,基本就可以按照这种方式切分到多张卡上,大大地提升了训练扩展性。
同时呢我们刚刚提到,在反向传播的时候,它不仅依赖上一层,也依赖同一层前向传播的参数,这个时候既需要保留反向传播参数,也需要保留前向传播参数,会给显存带来进一步开销。因此他们提出了重计算(经典方法,优化显存的典型方法)
进一步来说,GPipe他们只保存两个设备之间的边界结果,而对于设备内的中间层则直接丢掉。反向传播走到哪一层,就临时把那一层的前向重新计算一下。 虽然增加了约33%的计算量,但是把显存开销从变成了 . 这样就可以训练更加庞大的模型。
并且论文进一步分析了,只要micro-batch切分的足够多,(达到设备数量的4倍以上)气泡的占比就可以忽略不计。
并且因为模型被切分成为了巨大的块,设备之间只需要传输块和块的结果,也降低了频繁通信的开销,所以即使是普通的网络,也可以很好地运行。
1F1B 2021 Megatron-LM#
欢迎来到流水线并行最高的山、最长的河!
之前的GPipe和PipeDream都只是在学术领域探索的一些小打小闹,直到英伟达和斯坦福联合发表的Megatron-LM出世,才正式标志着大模型工业化的进程加速开启。
强烈建议这篇文章阅读原文。
话不多说,先把abstract端出来。
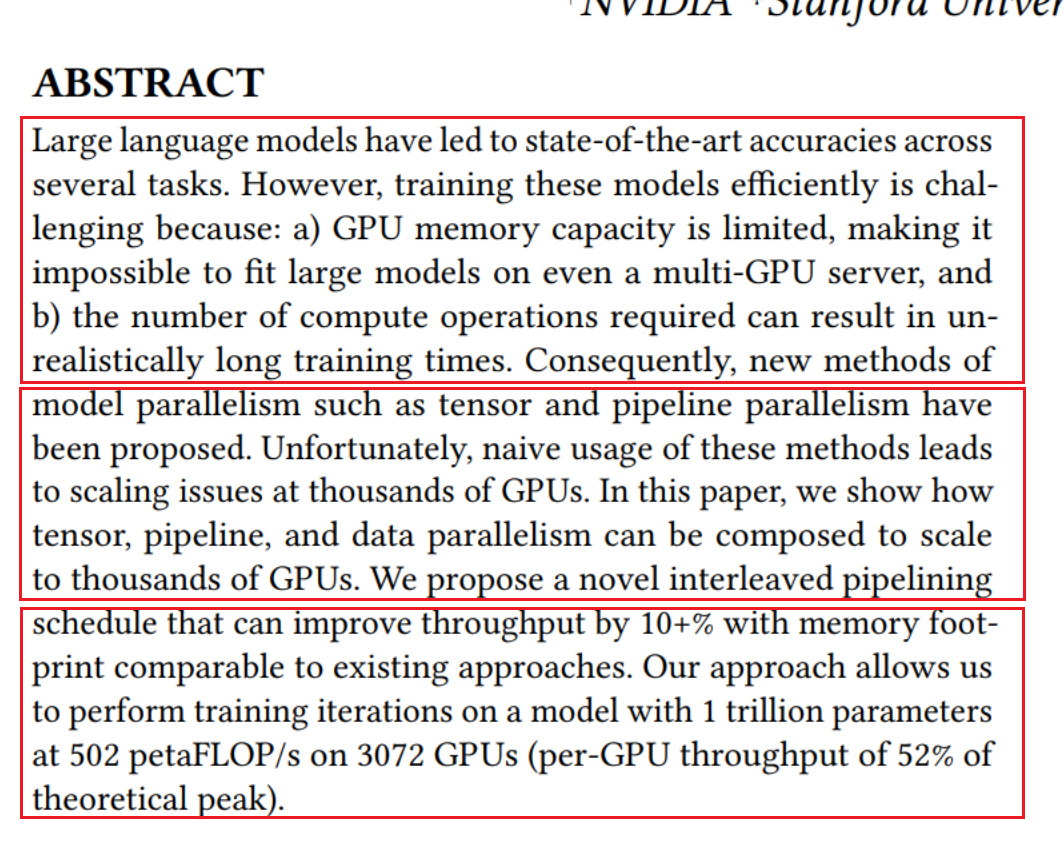
论文在Introduction中提到,假设使用一张A100-80G的GPU训练GPT-3,大概需要288年,更何况A100完全无法容纳整个大模型。 因此他们引出了并行范式。
在诸多并行范式中,数据并行是最早被使用的。它的核心是scale-out。但是数据并行DP有两个最明显的问题:
- 有可能每个GPU处理的数据都非常少,让GPU利用率变低
- 单个GPU无法放得下整个模型,同样限制训练
因此除了DP之外,一些新的并行技术例如最经典的张量并行,它在单机多卡内是很有优势的,可以把大模型分配在多个卡上。
但是仍然会有两个很明显的问题:
- 大量的all-reduce通信开销,需要高强度的卡间通信网络
- 张量并行如果被拆分的特别多,会把大矩阵变成小矩阵,反而降低GPU利用率
因此除了DP和PP,之前我们在Gpipe和PipeDream中提到的流水线并行就被派上了用场。 流水线并行核心就是把模型按照层进行切分,同时再把一个bath拆分成为更小的microbatches。 但是在流水线冰箱中,不管是哪种调度策略,都需要确保优化器也就是参数更新在各个设备之间同步。 很明显的一点是在每个批次的最末尾,都会出现一次流水线刷新。
根据论文的表述,高达50%的时间可能会花在刷新流水线上。而微批次和设备数的比例越大,则刷新时间越低。 因此为了实现高效率,通常采用更大的批次。 而1F1B的核心工作就是提出一种新的流水线调度策略,可以在较小的批次下提升效率、降低显存开销。
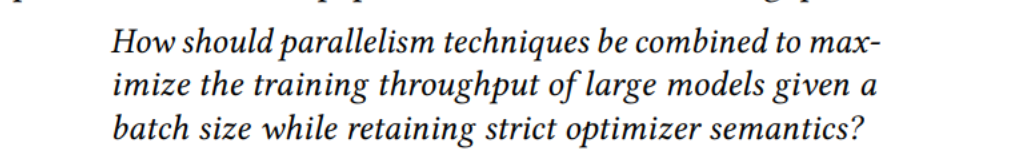
Introduction中介绍了Megatron-LM的核心问题:
在给定批次大小的情况下,应用各种并行技术,最大化模型训练吞吐,同时保持严格的优化器语义。
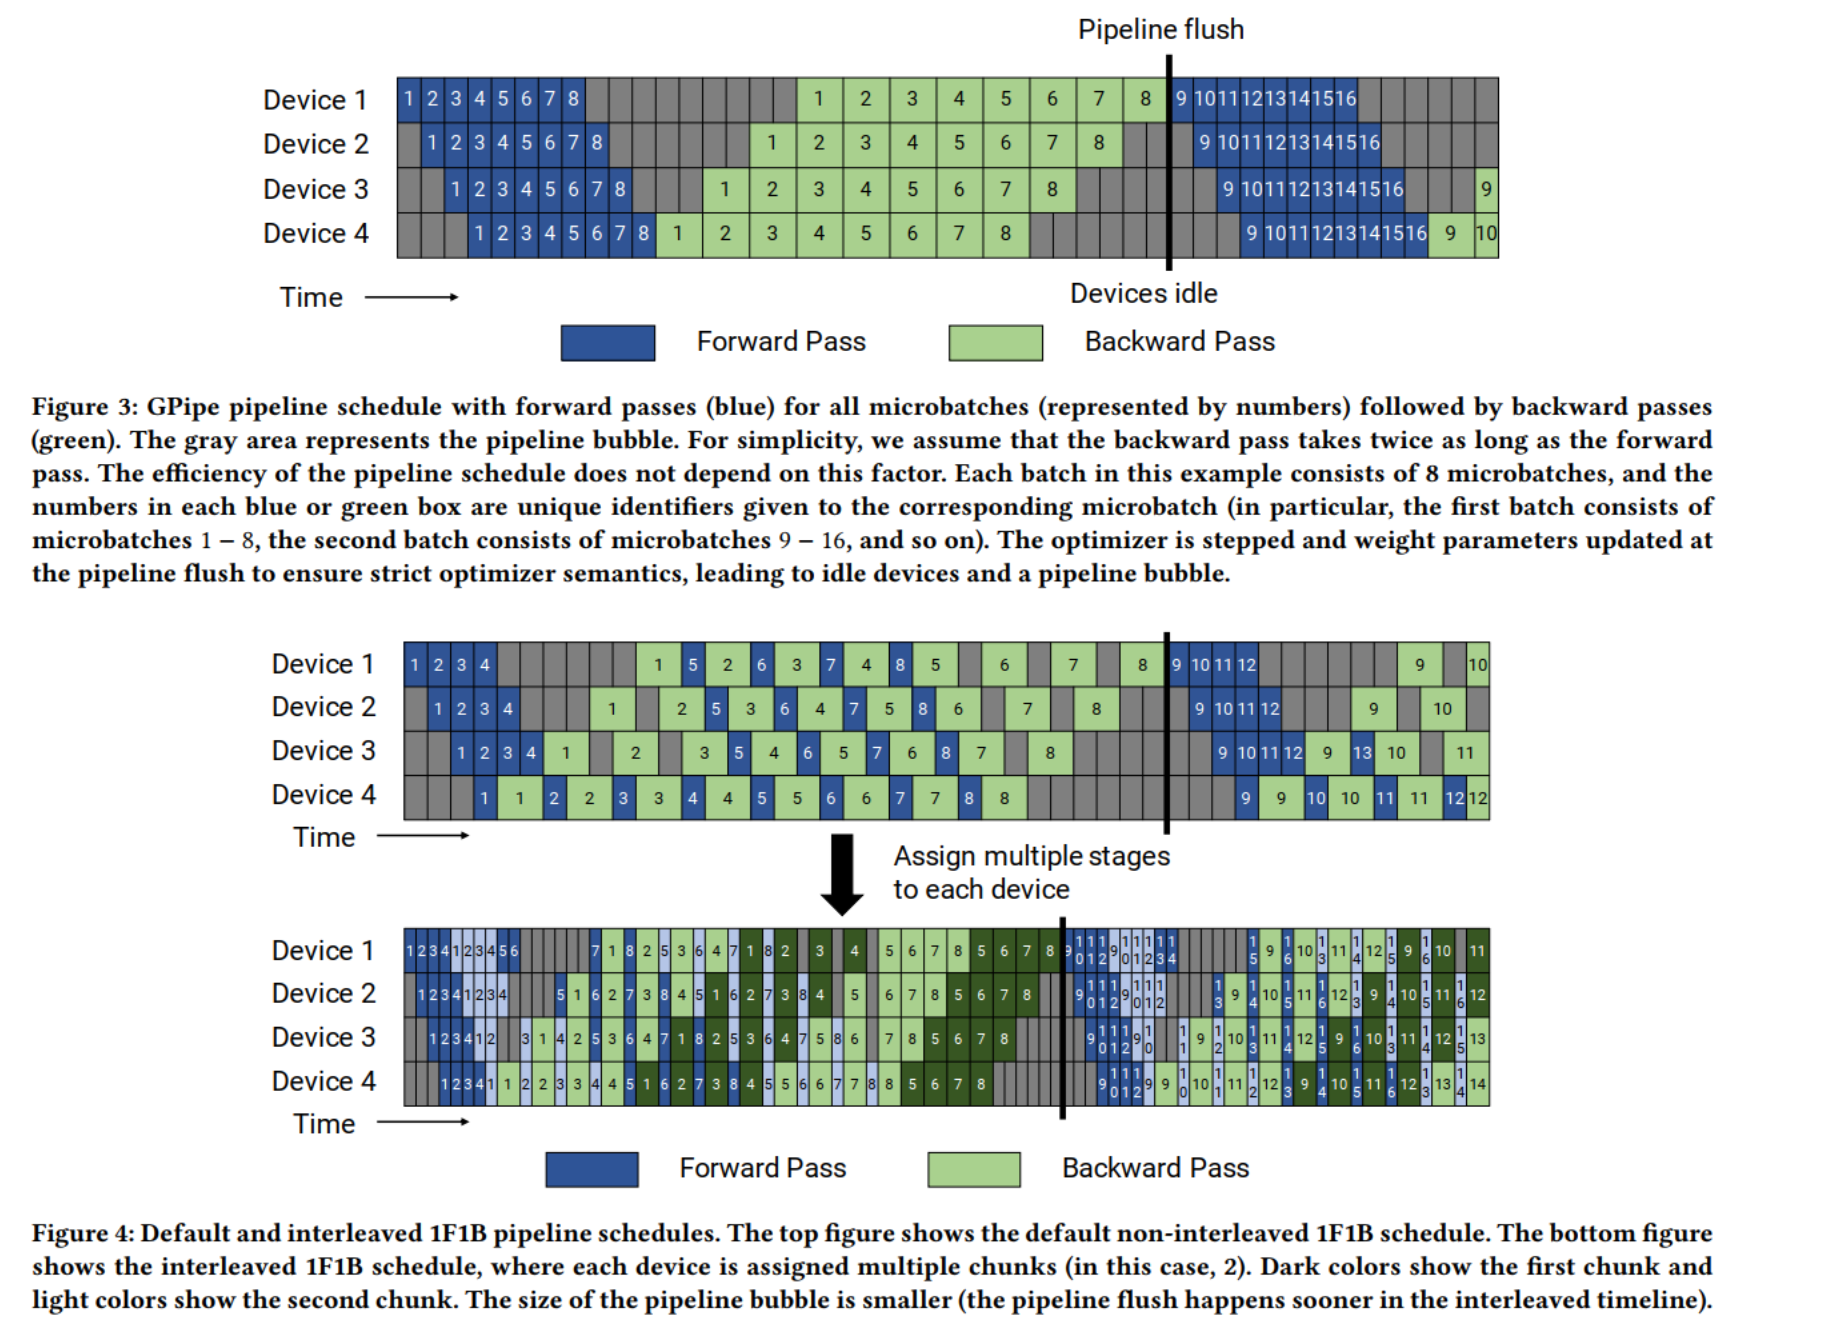
这个图比较复杂,我需要一步步带着大家讲解清楚。
首先图3是GPipe,它提出了一种调度方案,即先执行一个批次的所有F,再执行所有的B。假设GPipe的一个气泡大小为, 我们通过一些数据来量化这个气泡。
首先将一个batch中micro-batch的数量记为 , 流水线段数为 .
- 流水线气泡的开销为: (流水线气泡由一个batch开始时的p-1个前向传播和p-1个反向传播组成)
- 理想处理时间为
则气泡率为:
为了让这个气泡时间占比变小,因此需要m远远大于p。
但是GPipe需要将所有的m个批次的中间激活值保留(或者重计算),因此当m很大时,显存占用极高。
因此第一个优化就是PipeDream-Flush调度方案。如图4上所示,先让各个设备进入预热节点。等到各个工作节点进入稳态时,执行一次前向传播,紧跟着就是一次反向传播,简称为1F1B。
最后再一个batch结束的时候,返回所有的in-flight microbatches(尚未完成反向传播且需要维护激活值的micro-batch)。这个调度方案产生的气泡与上一个是相同的,它的主要优化点是只需要保存p次激活值,因此内存效率要比GPipe效率高非常多。
实际上1F1B已经效果比较好了,但是我们并不满足于此,请看图4下方。 为了进一步减少流水线气泡的大小,每个设备都可以执行模型的多个层的子集。
什么意思呢?假设原本设备1是拥有层1-4,设备2是层5-8,那么我们可以让每个设备计算两个模型块,即
- 设备1拥有层1,2,9,10
- 设备2拥有层3,4,11,12
- 以此类推
这种方案中,流水线的每一台设备都被分配了多个流水线阶段,例如假设一个设备有v个阶段,那么实际气泡占比为:
这就意味着这种新的调度方案进一步将气泡时间减少了v倍。 但是这种缩小的流水线气泡代价是用通信换取的。 从数量上讲,通信量也增加了v倍,因此需要更加高效的网络来降低额外通信带来的影响。
例如我在双卡H100上实测数据为:
Seq 2048,batch 4,eager。单位为 µs/token(步时 s),越低越好。
| m | 1F1B | GPipe | 交错 v=2 | 交错 v=3 |
|---|---|---|---|---|
| 2 | 32.84(0.538) | 32.91(0.539) | 28.81(0.472) | 27.59(0.452) |
| 4 | 28.17(0.923) | 28.14(0.922) | 26.21(0.859) | 25.69(0.842) |
| 8 | 25.86(1.695) | OOM | 24.89(1.631) | 24.78(1.624) |
| 16 | 24.65(3.231) | OOM | 24.39(3.197) | 24.37(3.194) |
峰值显存(GiB)开销如下:
| m | 1F1B | GPipe | 交错 v=2 | 交错 v=3 |
|---|---|---|---|---|
| 2 | 29.17 | 41.98 | 33.48 | 35.33 |
| 4 | 29.17 | 70.41 | 33.89 | 35.92 |
| 8 | 29.17 | — | 33.92 | 35.95 |
| 16 | 29.17 | — | 33.92 | 35.95 |
Megatron在论文中提出的一个核心的点是:
- 机内张量并行,跨机流水线并行
在卡数和批次固定的情况下,张量并行度越大,流水线切分段数就越小,因此气泡的等待时间就越小。
那是不是要无限加大张量并行呢? 非也!
从通信的角度来看,PP的通信是极其廉价的,只在段落和段落之间传输数据,通信方式还是点对点通信,每个micro-batch只需要传输一次。 而张量并行每一层都要进行all-reduce,前向两次,反向两次。 只有单机内部存在NVLink才能扛得住这种高频通信,一旦跨机器带宽骤降,TP的优势会显著下降。
那我可以不可以做单机内的PP呢?也可以。 但是要取决于单机有没有很好的通信环境。 假设现在8卡之间是NVLink全互联,那PP的通信数据量是不足以占满这么大的带宽的,完完全全被浪费掉了。相反TP可以很好的占用这部分带宽。
并且单机内做PP,气泡代价比较大,为了减少气泡,假设现在P是8,则M至少32,并且还要保存8份激活值,再加上模型状态,显存又变成了核心问题。
进而论文又分析了张量并行、数据并行和流水线并行之间的关系。那他们是什么关系呢? 简单来说就是模型并行度——张量并行和流水线并行,刚好能够把模型塞到显存即可,剩下的所有GPU都去做数据并行。这是因为只要是模型权重并行,就会有通信开销,因此只需要能够让卡刚刚好放得下模型,这是性价比最高的方式。
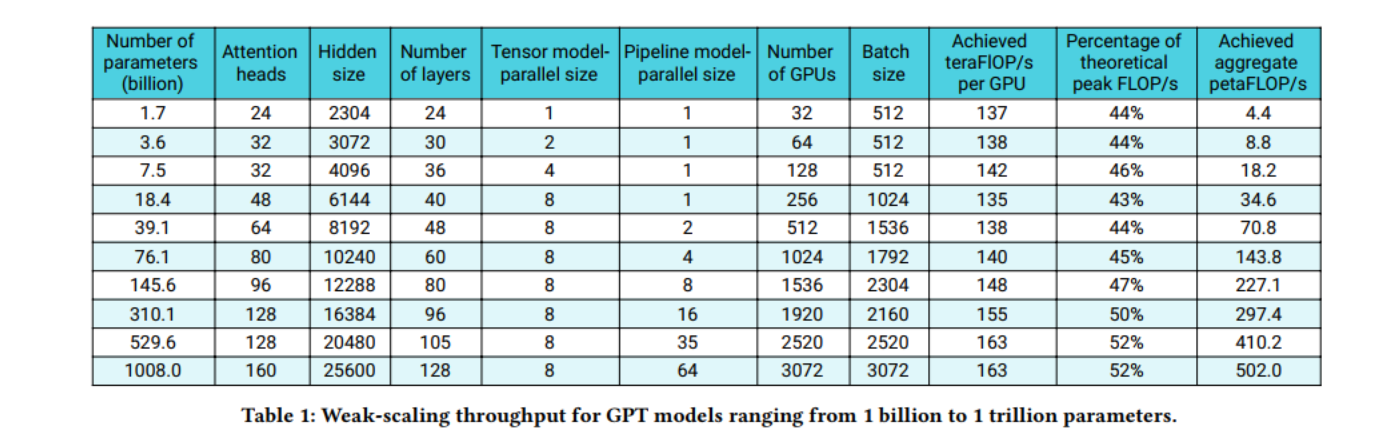
这张图就是纯纯的秀肌肉,他们证明了Megatron是可以无限扩展的,无论模型多大都可以训练,只要卡足够多。并且他们还进一步证明了,他们的系统在扩展时的效率极高,直接碾压了当时的ZeRO-3.
表中提到了弱扩展。这里指的是在增加机器的同时,同比例增加模型大小,查看单卡的计算效率是否能够维持。强扩展指的是保持模型不变的同时增加卡,减少执行时间。
仔细观察表格中的张量并行,它最大就是8,之后增长的主要内容是流水线并行度。
最后三列说明随着模型不断增大,单卡的算力不仅没掉,反而还从137涨到了163. 峰值利用率也从44%提升到了52%。
为什么模型越大,单卡效率反而越高了呢?
这是因为大模型的隐藏层维度和矩阵尺寸比较大,GPU是很喜欢算大矩阵的,这个时候的运算是计算密集,性能反而会进一步提升。
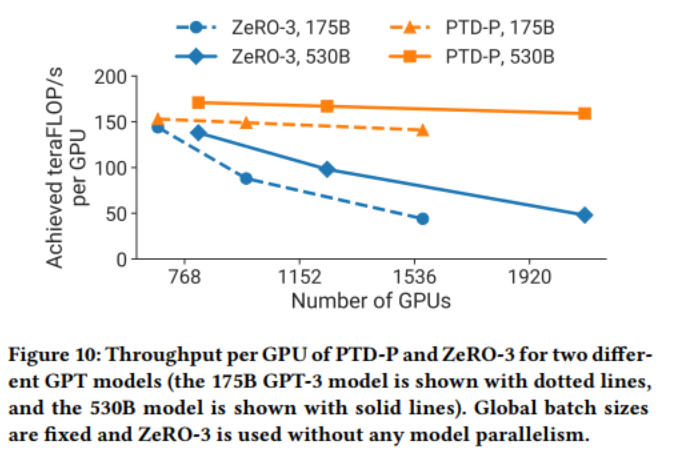
ZeRO-3我们在之前已经讲过,它本质上是一种数据并行,当GPU翻倍的时候,All-Reduce通信量也要跟着翻倍,于是当卡变成1500多张的时候,网络带宽直接被拉爆了。
其他的数据大家就自行在论文中查看吧。
到此为止我们就把流水线并行最核心的内容基本上讲解完毕了。
Zero Bubble(2023 / 2024,Sea AI Lab)#
1F1B 把一次反向作为一个整体安排。Sea AI Lab 在 Zero Bubble 中进一步区分了反向的两部分工作:B 计算输入梯度,交给上一阶段;W 计算参数梯度,留给本卡更新。 上一阶段要等 B 的结果,W 则可以在本轮参数更新前完成。Zero Bubble 论文,第 2 节
我们可以通过线性层 看清这个区别。后面传来的输出梯度记为 ,本层要计算
如果先算出 B 并发回去,上一张卡就能继续反向,本卡可以稍后再算 W。等到本卡因为前向输入或反向梯度尚未到达而需要等待时,就能插入之前暂缓的 W,利用这段空闲。
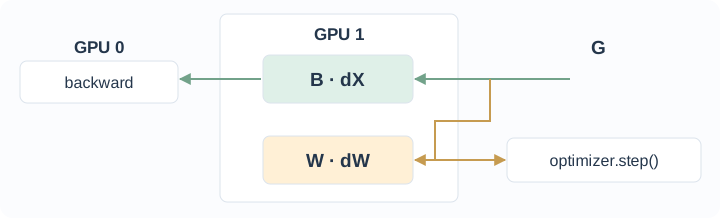
我们再看刚才的线性层。计算参数梯度需要 和 ,所以 W 往后放时,这两份数据也要继续留在显存里。等 W 算完,相关数据才能释放。这样一来,推迟 W 能让输入梯度更早传回上一张卡,同时也延长了一部分数据的保存时间。
ZB1P 与 ZB2P#
Sea AI Lab 基于这个关系设计了 ZB1P 和 ZB2P。两种方式保持相同的模型切分,主要区别是允许多少个微批的反向计算尚未完成。我们可以先把它们理解为两档显存安排:ZB1P 使用接近普通 1F1B 的激活预算,ZB2P 则允许大约两倍的预算。
名字里的 表示流水线阶段数,1P、2P 对应按 和 设置的待反向微批上限。沿用前面的 4 段流水线,这两档上限就是 4 个和 8 个微批。能够同时保留更多微批的数据,调度器就有更多可以提前或推迟的任务。作者的调度说明
我们先看 ZB1P。它优先计算会影响上一阶段的 B,把一部分 W 留到后面。如果继续接收新微批会超过显存预算,就先完成一些 W,释放对应的数据,再执行新的前向。这样能减少等待,同时把激活峰值控制在接近 1F1B 的水平;显存预算也限制了 W 能推迟多远,因此仍会留下一部分气泡。
ZB2P 把这部分预算放宽,让更多微批提前进入流水线。我们因此可以在预热时多做一些前向,更早准备好后面的反向任务,再把更多 W 安排到原本空闲的位置。它用更大的激活占用换取更多调度空间,在论文的理想条件下可以把计算气泡消除。
| 调度 | 相对 1F1B 的激活预算 | 调度效果 |
|---|---|---|
| 普通 1F1B | 约 1 倍 | 输入梯度与参数梯度一起计算 |
| ZB1P | 约 1 倍 | 拆开 B/W,利用空闲时间计算部分 W,减少气泡 |
| ZB2P | 约 2 倍 | 容纳更多未完成反向的微批,进一步推迟 W,可消除理想计算气泡 |
这里的理想条件,是论文先假设 F、B、W 三部分耗时相等,并且有足够多的微批可供安排。实际模型中,我们还要根据这三部分各自的耗时重新排布任务,所以作者又设计了根据实测耗时和显存限制生成调度的算法。
参数更新时的等待#
计算排满以后,参数更新仍可能需要等待。例如做全局梯度裁剪时,我们需要先汇总各阶段的梯度大小,才能决定是否缩放梯度。各卡走到这里,又会遇到一次同步。
作者进一步将这类检查改成更新后验证:先按无需调整梯度的情况更新,同时完成检查;如果发现需要裁剪或存在数值异常,就撤回这次更新,再按检查结果处理。这个设计继续减少了更新前的等待,也是论文实现接近零气泡的重要部分。作者对更新后验证的说明
回到项目代码,pp-zb 使用的是接近 ZB1P 的安排。我们可以在 training/scheduling/zerobubble.py 中看到,它先保留 1F1B 的 F/B 顺序,遇到依赖尚未满足的空档,再选出一个已经可以计算的 W。每卡保留的未完成微批数也受到流水线深度的限制。这样就把前面的 B/W 拆分、W 填充和激活预算对应到了具体实现。
DualPipe(DeepSeek-V3)#
Zero Bubble 让我们看到,反向里的两部分工作可以分开安排。DeepSeek-V3 的 DualPipe 继续把计算和通信拆得更细,希望在一组微批等待数据传输时,GPU 能计算另一组微批。
我们可以先通过前面的 16 层、4 张卡理解它的双向布局。第一组微批从 GPU 0 进入,依次在 GPU 0、1、2、3 上完成第 1–4、5–8、9–12、13–16 层。另一组微批从 GPU 3 进入,在 GPU 3、2、1、0 上完成相同的层顺序。DualPipe 官方示例
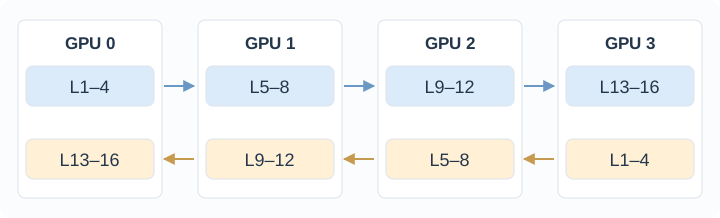
从图里可以看到,两组数据都按模型原有的层顺序计算,只是模型副本在设备上的摆放方向相反。因此,GPU 0 同时保存第一条路线的第 1–4 层和第二条路线的第 13–16 层,其余 GPU 也各保存两个对应的模型块。两条路线更新时需要合并相同参数的梯度,共同训练这个模型。
这样,流水线两端都能接收新微批,各张卡也有来自两个方向的任务可以安排。例如,一张卡正在等待其中一路的反向梯度时,就有机会处理另一路已经准备好的前向任务。DualPipe 在此基础上,把一组前向和一组反向中的计算、通信进一步交错。
我们再看 DeepSeek-V3 使用的 MoE 层。token 需要先发到专家所在的设备,专家算完后再把结果传回来。这两次传输之间,还有注意力、专家矩阵乘等计算可做。DualPipe 将这些操作分别安排,并继续拆开反向中的输入梯度与参数梯度,让一组任务的传输与另一组任务的计算重叠。DeepSeek-V3 技术报告,第 3.2.1 节
因此,双向布局提供了更多可以交错的任务,层内拆分则让调度器能找到具体的重叠位置。我们在实际接入时,需要根据模型实现对应的前向、反向重叠逻辑,官方示例中的 overlapped_forward_backward 就是这部分接口。
相应的显存代价也能从图里看出来。每张卡保留了两组模型块,整条流水线保存两套参数副本。DeepSeek-V3 的比较表中,DualPipe 的参数存储是普通 1F1B 的两倍;按论文的激活统计方式,峰值从 份增加到 份。我们获得了更多并行安排的机会,也需要为这些任务准备相应的存储空间。DualPipe 的气泡与显存比较